Resumen de información suprimida: Como parte de esta evaluación, Anthropic tenía derecho a suprimir cualquier información no pública en este informe. Conforme a nuestro enfoque de transparencia, teníamos derecho a divulgar si Anthropic ejercía su facultad de supresión y si alguno de nuestros hallazgos dependía de manera significativa de la información suprimida. Si bien pudimos compartir libremente nuestras conclusiones de más alto nivel sobre riesgo, Anthropic suprimió la mayoría de la evidencia que consideramos más relevante para sustentarlas. Anthropic describió las supresiones como “orientadas a eliminar información confidencial que podría acelerar a otros desarrolladores de IA.”1 Algunas de estas supresiones son, en sí mismas, difíciles de describir con claridad sin revelar información sensible que se nos ha pedido mantener confidencial. En la sección dedicada a nuestra metodología que aparece más adelante, presentamos una tabla detallando qué elementos importantes de evidencia pudimos abordar y cuáles no, a raíz de dichas supresiones. Todas las supresiones que fueron relevantes para nuestras conclusiones se encuentran reflejadas en las descripciones de dicha tabla o en otras descripciones incluidas en el informe que se presenta a continuación.
Gran parte de la evidencia suprimida que revisamos admitía múltiples interpretaciones plausibles, y tanto los investigadores de METR como los de Anthropic tienen una incertidumbre significativa sobre cómo integrar dicha evidencia en un panorama integral. Esto dificulta que el público pueda evaluar por sí mismo esta evidencia, la concilie con la de otras fuentes y llegue a sus propias conclusiones (es decir, este informe no logra la ‘transparencia sobre la evidencia’). Como consecuencia, el público debe confiar en el criterio de METR en mayor medida de lo que sería deseable, dado el peso de las preguntas que aquí se responden.
Resumen ejecutivo
Del 12 de agosto al 29 de octubre de 2026, el personal de METR realizó una evaluación de alto acceso en Anthropic para determinar en qué medida la IA está acelerando la investigación y el desarrollo (I+D) en IA.2 Si los sistemas de IA comenzaran a acelerar de manera significativa el desarrollo futuro de IA, esto podría dar lugar a la aparición repentina de capacidades extremas y riesgosas.
Anthropic ofreció un acceso sin precedentes a datos internos sobre sus procesos de I+D en IA, que incluyó una variedad de métricas sobre preentrenamiento, aprendizaje por refuerzo (RL, por sus siglas en inglés), cómputo para entrenamiento en cada disciplina, puntajes en pruebas de referencia (benchmarks) de modelos internos, análisis sobre la aceleración de la IA, proyecciones de las métricas de un modelo futuro y entrevistas con el personal pertinente.
En la primera sección compartimos nuestras conclusiones subjetivas sobre riesgo. Actualmente consideramos que:
- A octubre de 2026, es probable que Anthropic esté mejorando las capacidades de sus modelos en tareas bien delimitadas a una tasa aproximadamente dos veces superior a la observada entre marzo de 2024 y octubre de 2025. Esta estimación conlleva un alto grado de incertidumbre; no nos sorprendería que la aceleración real fuera más cercana a 1.3 o 3 veces la tasa histórica.
- Es probable que la mayor parte de esta aceleración actual se deba al uso extensivo que hace Anthropic de la IA para realizar I+D, aunque existe una incertidumbre considerable y es probable que otras causas hayan desempeñado un papel importante en la aceleración registrada a finales de 2025.
- La ausencia de cuellos de botella observados o de fuertes rendimientos decrecientes implica que existe un riesgo considerable de que un mayor avance en las capacidades pueda conducir a una aceleración aún mayor, aunque, como señalamos más adelante, es posible que estemos pasando por alto cuellos de botella importantes.
En la segunda sección compartimos algunos de los hallazgos empíricos clave de nuestro informe completo:
- Desde octubre de 2025, los puntajes en pruebas de referencia (benchmarks) de los modelos de Anthropic (medidos mediante AECI, la versión de Anthropic del Índice de capacidades de Epoch) han crecido a una tasa estimada de 1.9 veces la registrada antes de octubre de 2025 [intervalo de confianza del 95%: 1.5–2.8 veces]. Esto implica que Anthropic ha logrado, en el último año, aproximadamente dos años de progreso al ritmo histórico.
- Estamos convencidos de que esta aceleración no se debió a una aceleración en el aumento del cómputo para entrenamiento.
- Las entrevistas y encuestas son compatibles con que el uso de la IA haya duplicado el ritmo al que avanzan las capacidades. El personal de Anthropic reporta, en entrevistas y encuestas, un incremento drástico gracias al uso de sistemas de IA, aunque estas declaraciones son difíciles de interpretar. Se nos indicó que la I+D se acelera principalmente mediante la asistencia de la IA, en lugar de contribuciones totalmente autónomas, pero existen ciertos indicios de que las contribuciones completamente autónomas desempeñarán pronto un papel más relevante.
- No observamos indicios de cuellos de botella significativos que, en los próximos 12 meses, pudieran impedir un mayor avance en las capacidades debido a limitaciones en el progreso algorítmico, la capacidad de cómputo para el entrenamiento o la experimentación, o la disponibilidad de datos. Sin embargo, nuestra comprensión del estado de distintos cuellos de botella cambió varias veces a medida que recibimos información más detallada, por lo que no tenemos confianza en nuestra evaluación actual.
Algunos de los hallazgos clave que más influyeron en nuestras conclusiones sobre riesgo fueron suprimidos por Anthropic.
En la tercera sección, describimos el proceso de evaluación:
- El alcance, la configuración y el cronograma de esta evaluación.
- Detalles de la información compartida con METR.
- Detalles de la información y la evidencia que no pudimos compartir debido a las supresiones realizadas por Anthropic.
Por último, describimos las principales limitaciones de nuestro análisis:
- Podríamos estar subestimando la aceleración de las capacidades si no otorgamos suficiente importancia a (1) los indicios de que algunas tasas de crecimiento han aumentado aún más recientemente; (2) una mayor automatización de las tareas de I+D en IA, que daría lugar a una aceleración todavía mayor del progreso; (3) la evidencia de que el crecimiento en AECI ha subestimado, en ocasiones, el crecimiento del impacto en el mundo real.
- Podríamos estar sobrestimando la aceleración de las capacidades si no otorgamos suficiente importancia a (1) los factores ajenos a la IA en el avance de la investigación de Anthropic; (2) el enfoque del AECI en tareas verificables; (3) las razones por las que la tasa de crecimiento inicial de Anthropic (2023–2025) fue inusualmente baja.
El resto del informe analiza al detalle cada uno de los componentes clave. También incluimos apéndices con material complementario.
Nuestras conclusiones subjetivas sobre riesgo
Nuestras conclusiones sobre riesgo.
Independientemente de esta evaluación, METR publicó en octubre de 2026 un artículo que plantea un conjunto de preguntas de alto nivel sobre la aceleración de la I+D en IA que, a nuestro juicio, el público necesita comprender para poder evaluar los riesgos de pérdida de control derivados del desarrollo de IA de frontera. En esta sección describimos cómo la evidencia que revisamos en esta evaluación modificó nuestras conclusiones subjetivas sobre estas preguntas de alto nivel.
Ritmo de avance de las capacidades.
Una aceleración significativa de la tasa general de progreso de Anthropic resultaría sorprendente, dado que los rendimientos decrecientes y la dependencia del cómputo a escala implican que esto probablemente requeriría un aumento notable de otras entradas.3 Tras revisar la evidencia interna, aún tenemos incertidumbre considerable y desacuerdos dentro del equipo, pero la mayoría del personal de METR que trabajó en este proyecto considera ahora que, a octubre de 2026, es probable que Anthropic esté mejorando las capacidades de sus modelos en tareas bien delimitadas a una tasa aproximada del doble en comparación con el periodo de marzo de 2024 a octubre de 2025. No nos sorprendería que la tasa de crecimiento actual estuviera más cerca de 1.3 veces o 3 veces la tasa histórica. También existe incertidumbre adicional sobre cómo se traduce esta aceleración a tareas más amplias y menos delimitadas.
La aceleración de 1.9 veces [intervalo de confianza del 95%: 1.5–2.8 veces] en la tendencia del AECI desde octubre de 2025, descrita más adelante, influyó de manera significativa en esta postura, pero podría explicarse por un sobreajuste (overfitting) a la distribución de las pruebas de referencia (benchmarks) o ser, de algún otro modo, un artefacto de la metodología del AECI. Por otra parte, no tenemos plena confianza en que el AECI nos permita estimar de manera fiable la aceleración reciente de la I+D, ya que los puntos de datos reflejan con cierto retraso la aceleración de la investigación y son relativamente escasos.
Más allá de la evidencia del AECI, también vimos evidencia suprimida que influyó de manera significativa en nuestra postura sobre esta cuestión y nos llevó a tomar más en serio esta aparente aceleración de aproximadamente 2 veces. Asimismo, nos dio algunos indicios de que la aceleración podría superar a ese factor de dos y aumentar con el tiempo, aunque nos sorprendería que fuera significativamente mayor.
Atribución a la IA.
Analizamos diversos factores que podrían explicar la aceleración observada, entre ellos el escalamiento del cómputo, la contratación de personal, las mejoras en los datos, los descubrimientos algorítmicos y la resolución de otros cuellos de botella.
Como describimos más adelante, pudimos determinar con seguridad que la aceleración no se debió a una aceleración en la tasa de crecimiento del cómputo destinado al entrenamiento. Más allá de eso, no hubo consenso entre el propio personal de Anthropic y no encontramos evidencia concluyente. Nuestra valoración subjetiva general es la siguiente:
- Es probable que la aceleración registrada a finales de 2025 haya sido influida por factores ajenos a la IA. Investigamos diversos factores que pudieron haber contribuido a la aceleración observada a finales de 2025, pero los detalles de muchos de ellos han sido suprimidos.
- Suponemos que la mayor parte (quizás ≈80%) de la aceleración actual (a octubre de 2026) se debe a la IA. Esta valoración se emite con una incertidumbre sustancial, pero se basa en diversas líneas de evidencia sobre las contribuciones de la IA y de otras causas. Creemos que la contribución de la IA ha cobrado una importancia relativamente mayor con el tiempo y no consideramos que los demás factores que investigamos expliquen esta aceleración sostenida. La evidencia de aceleración derivada del uso de la IA, que describimos a continuación, también parece compatible con una contribución significativa.
A continuación ilustramos estos puntos:
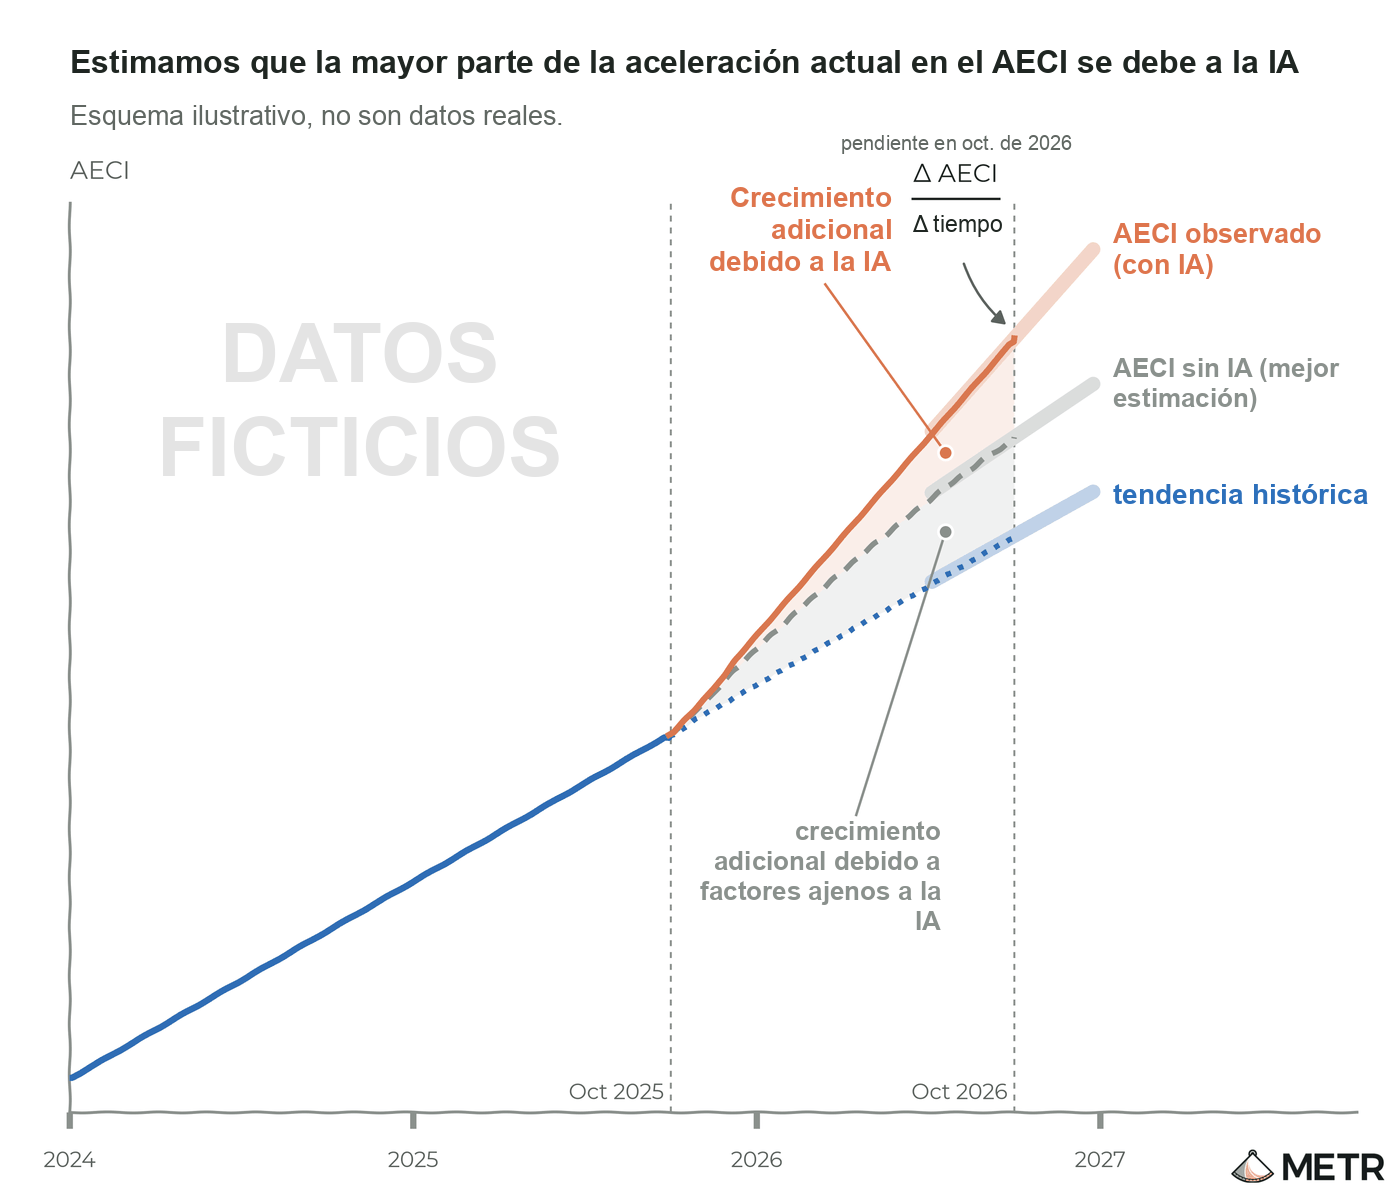
Nuestras estimaciones más detalladas de los efectos acumulativos e instantáneos de la IA sobre la tasa de progreso de Anthropic, medida mediante el AECI, así como en las distintas etapas del proceso de entrenamiento de modelos, fueron suprimidas.
Cuellos de botella para una mayor aceleración.
Una preocupación clave es que la aceleración derivada del uso de la IA comience a acumularse y retroalimentarse, a medida que el desarrollo de modelos más capaces genere una aceleración adicional. Como describimos más adelante, no identificamos cuellos de botella claros (entradas limitadas que impedirían un mayor crecimiento) ni rendimientos decrecientes pronunciados que obstaculizarían esa aceleración autorreforzada ante nuevos escalamientos. Sin embargo, nuestra comprensión de la situación evolucionó varias veces a lo largo de esta evaluación y tenemos una incertidumbre considerable. Por ello, creemos que existe un riesgo significativo de que nuevos avances en las capacidades puedan provocar una aceleración todavía mayor durante el próximo año.
Hallazgos clave
En esta sección resumimos los principales hallazgos empíricos de nuestro informe completo que podemos describir sin revelar información suprimida (consulte la sección sobre el proceso para más detalles sobre lo que fue suprimido).
Terminología: Describimos el crecimiento como múltiplos anuales y la aceleración como una proporción entre tasas de crecimiento.
Usamos “aceleración” para referirnos a un aumento en la tasa de crecimiento, de modo que una aceleración de 2 veces significa que el progreso que históricamente habría llevado 2 años se logra en 1 año.
Si la tendencia histórica del AECI fuese de 15 puntos por año, un aumento a 30 puntos por año implicaría una tasa de aceleración de 2 (se necesita 1 año para lograr 2 años de avance a la tasa anterior). En el caso de una variable que crece de forma exponencial, la tasa de aceleración es la proporción entre las tasas de crecimiento. Si una variable crece 3 veces por año, para lograr 2 años de avance en 1 año la tasa de crecimiento debe ser de (3²)x/año = 9x/año (y la aceleración puede expresarse como ln(9)/ln(3) = 2).
Desde octubre de 2025, los puntajes en pruebas de referencia (benchmarks) de los modelos internos han crecido a cerca del doble de su tasa histórica.
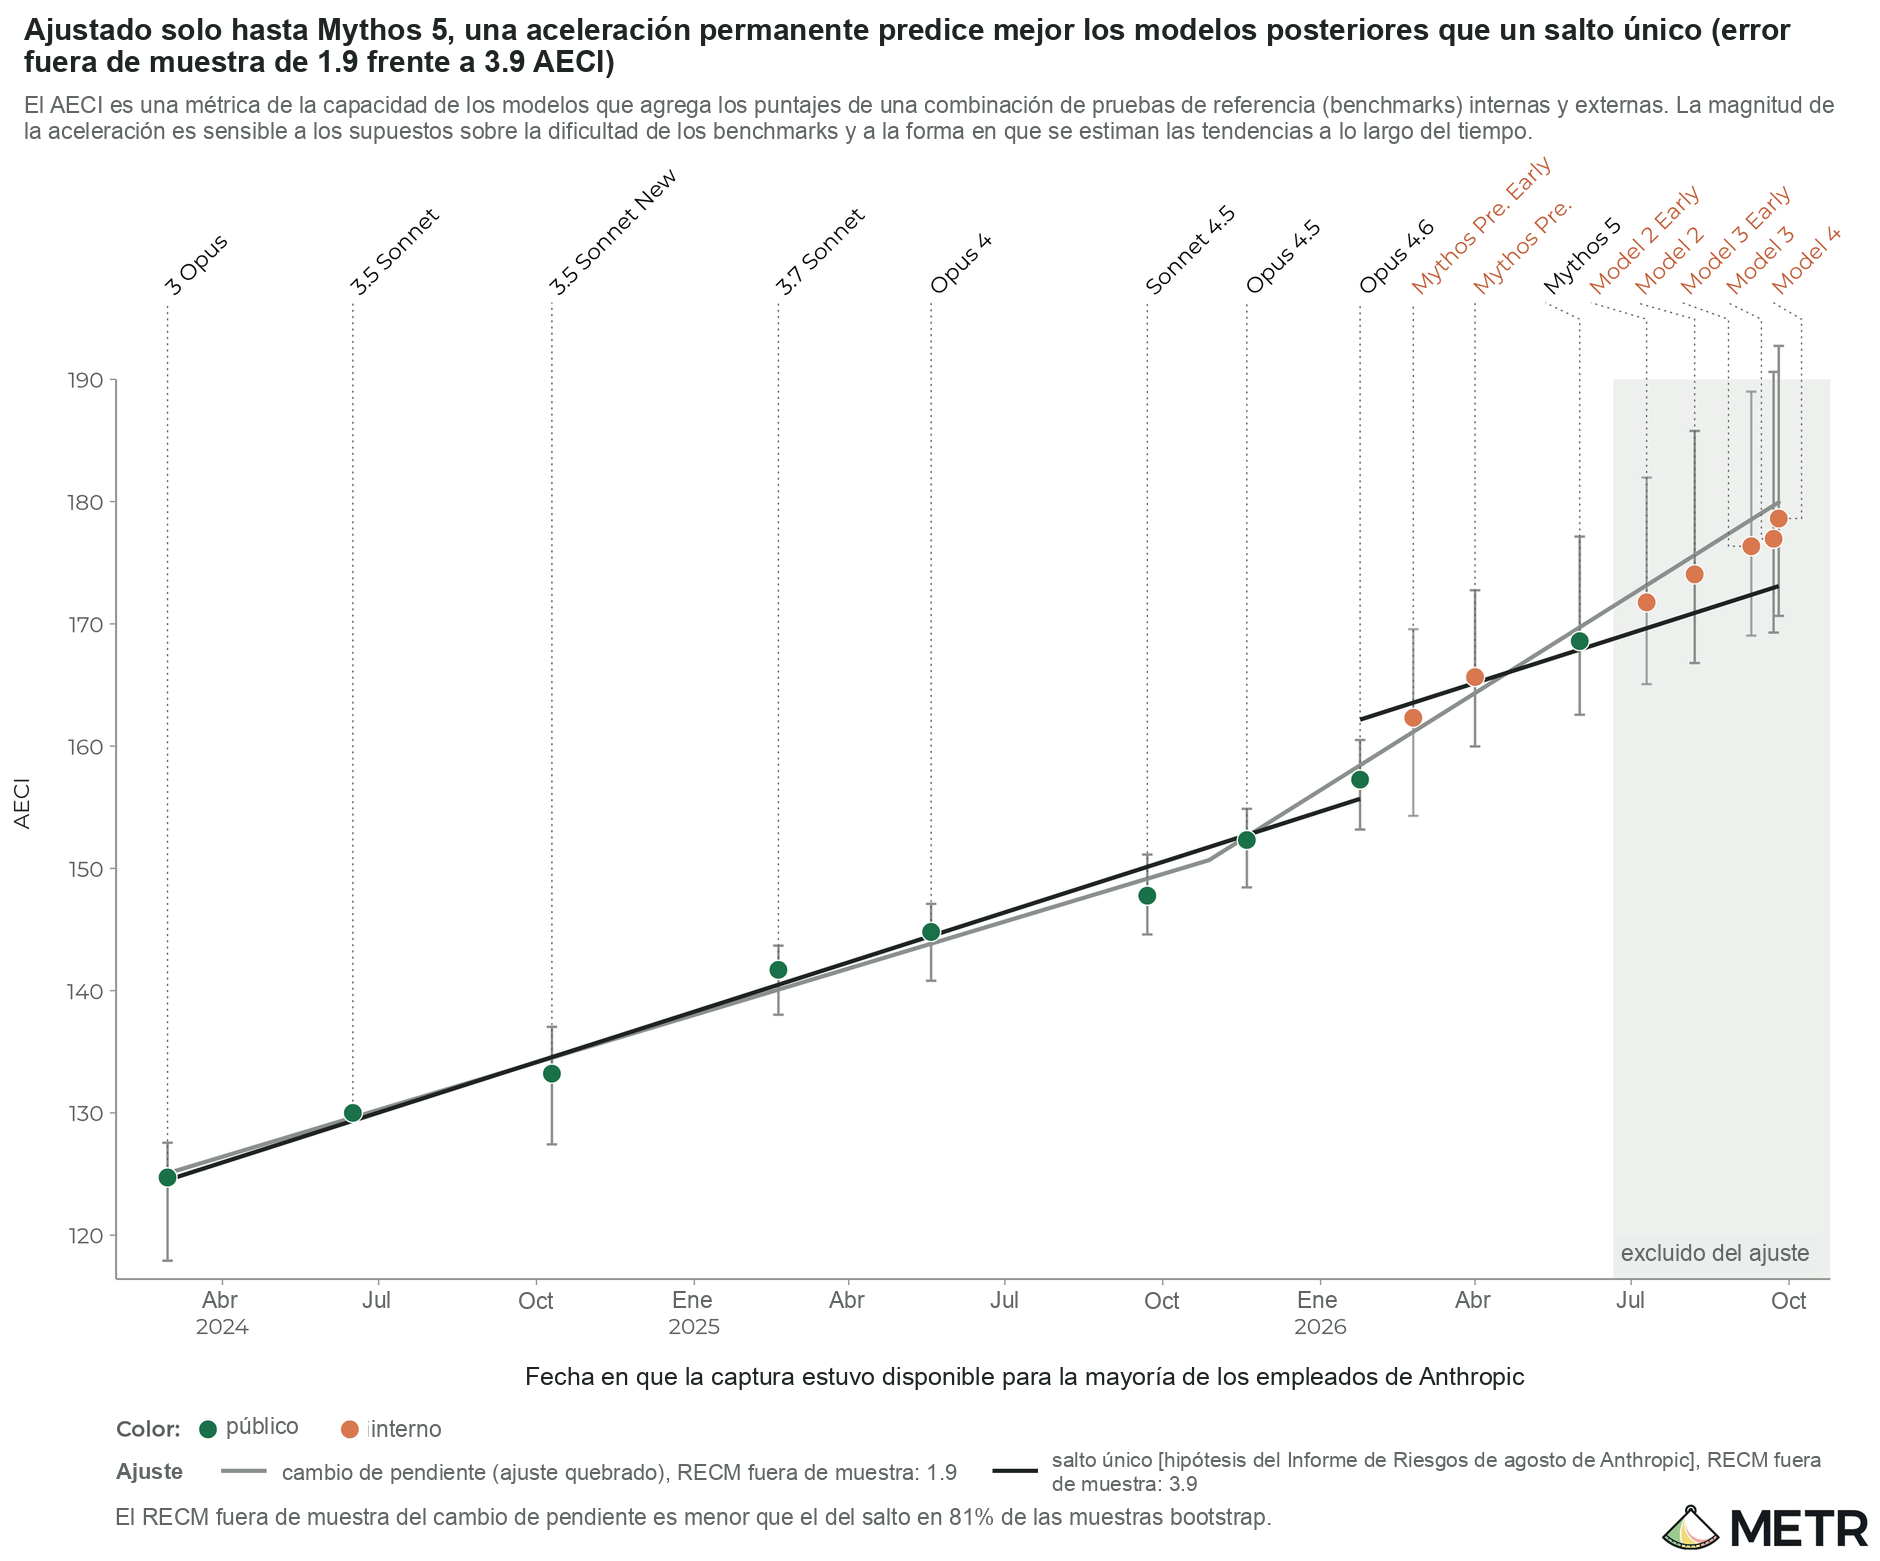
Los puntajes en pruebas de referencia (benchmarks) de los modelos de Anthropic, medidos mediante el AECI (la versión de Anthropic del Índice de capacidades de Epoch), se han acelerado 1.9 veces [intervalo de confianza del 95%: 1.5–2.8 veces] desde octubre de 2025. Dicho de otro modo, Anthropic parece haber logrado en el último año tanto avance en las pruebas de referencia (benchmarks) como el que logró entre octubre de 2023 y octubre de 2025 (aproximadamente, de Claude 2.1 a Sonnet 4.5):
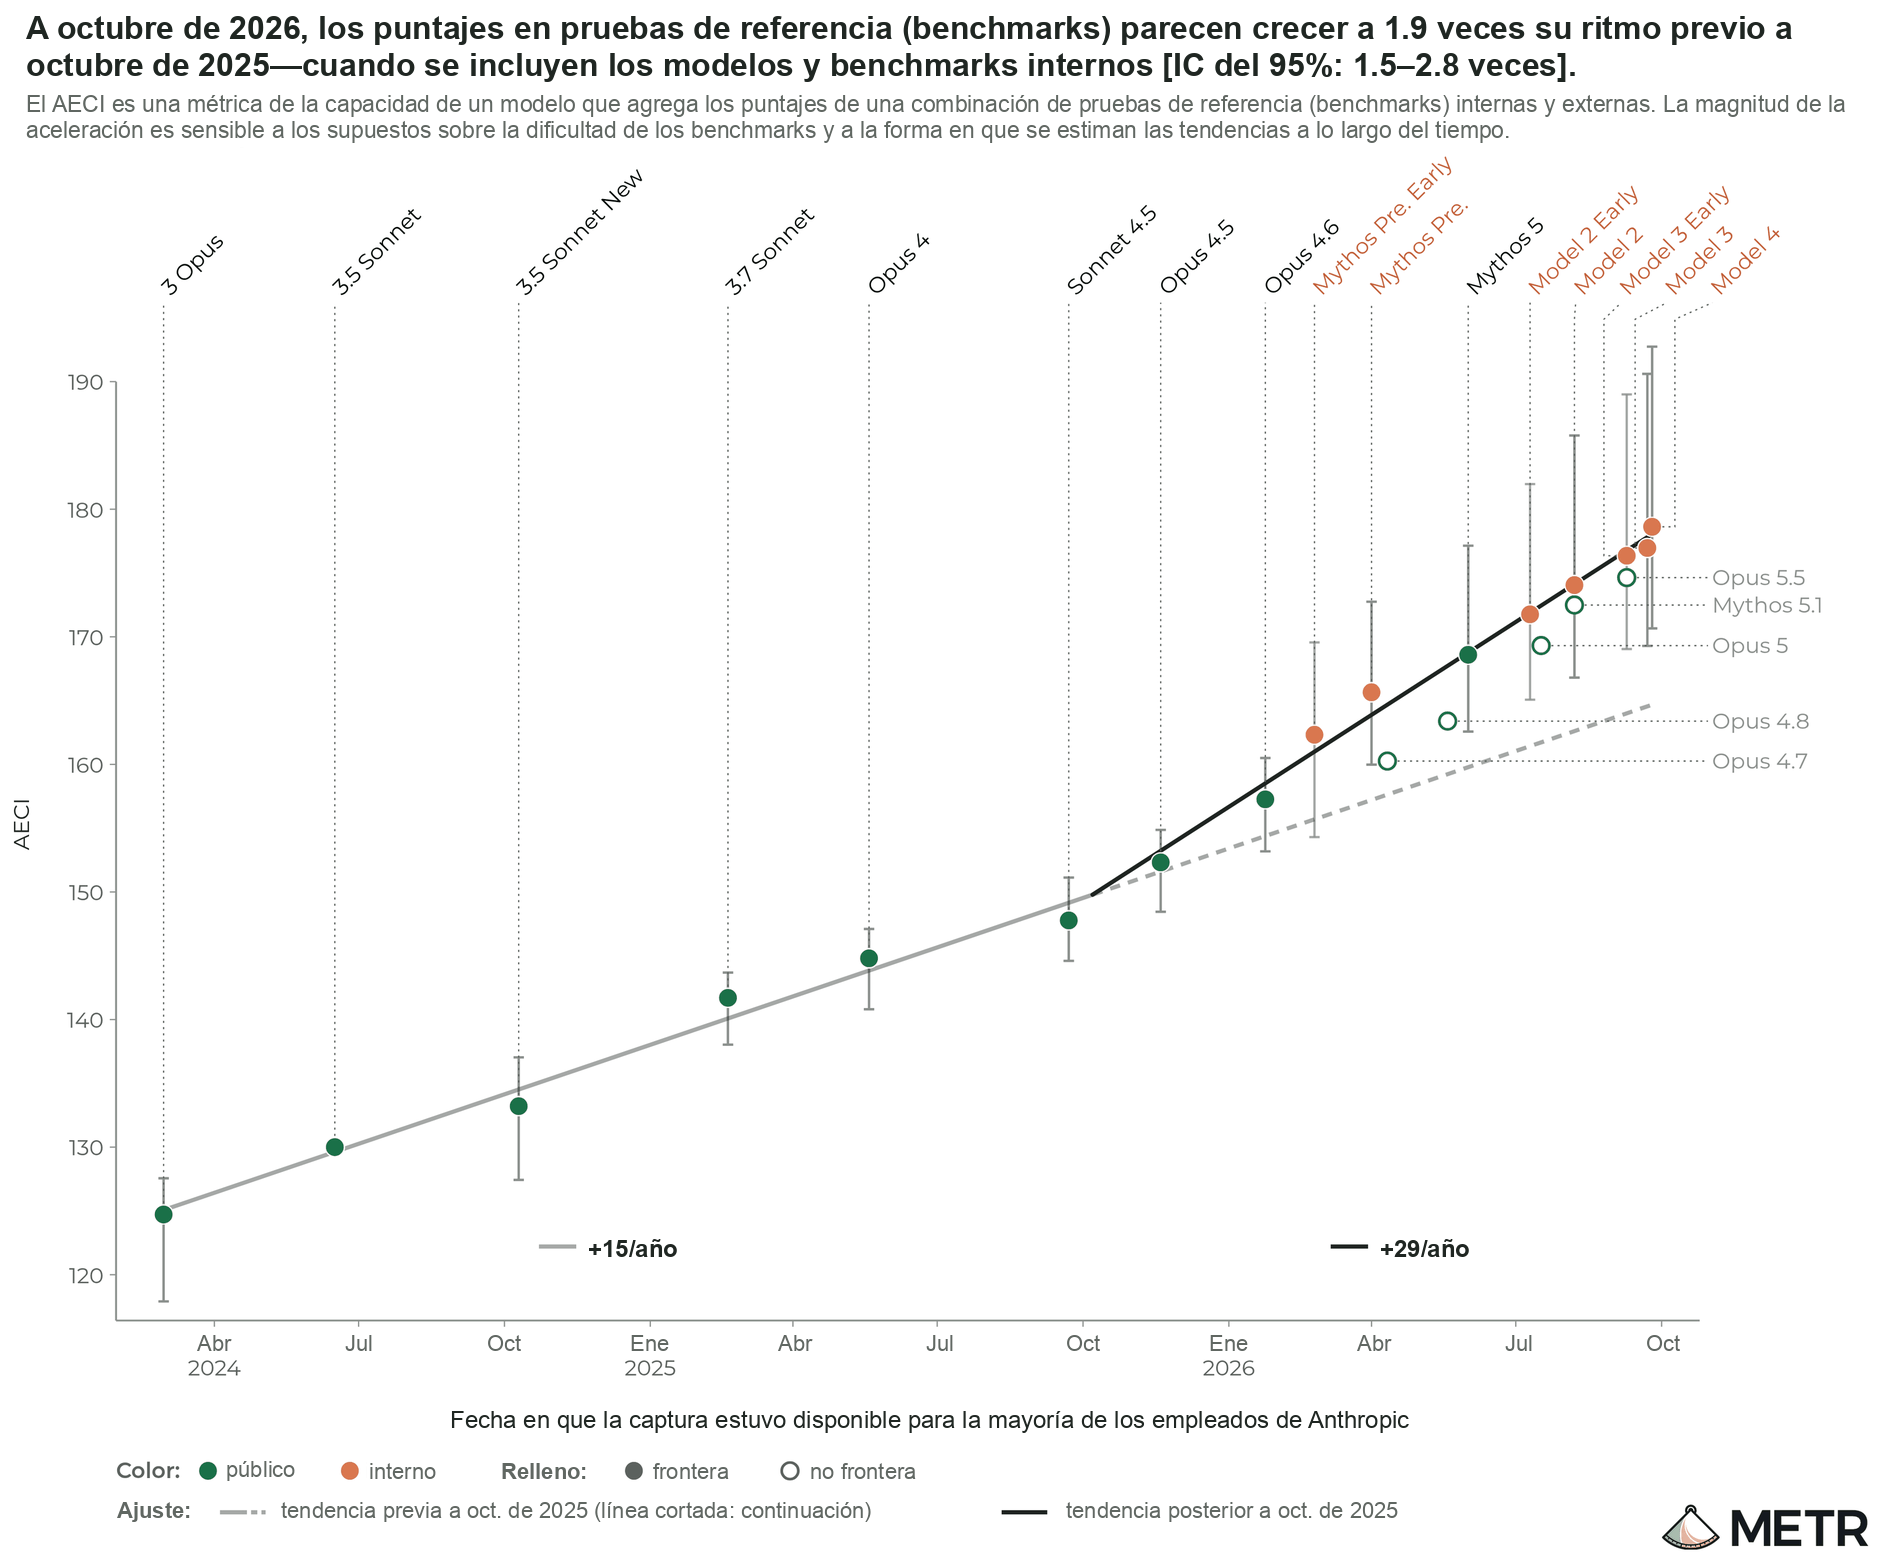
Nuestra estimación de la aceleración es mayor que la reportada en la ficha del sistema (system card) de Haiku 5.5 (1.7 veces), principalmente porque incorporamos datos de modelos más recientes que aún no se han lanzado, como explicamos con mayor detalle más adelante.
Investigamos la robustez de estos resultados ante distintas decisiones sobre la inclusión de pruebas de referencia (benchmarks), la asignación de fechas a los modelos, la inclusión de modelos y la saturación de las pruebas de referencia. Los análisis de robustez arrojan tasas de aceleración de entre 1.1 y 2.9 veces. Nos sorprendería que la evolución real de los puntajes en pruebas de referencia (por ejemplo, medida mediante una versión mejorada del AECI) no mostrara aceleración o mostrara una superior a 3 veces. Consulte los detalles en nuestra sección de apéndices.
La aceleración no está impulsada por una aceleración en la escala del cómputo destinado al entrenamiento.
Recibimos evidencia convincente de que la aceleración no se debió a una aceleración en la escala del cómputo destinado al entrenamiento. Los detalles adicionales sobre esta evidencia fueron suprimidos.
Las entrevistas y encuestas son compatibles con que el uso de IA esté impulsando esta duplicación del ritmo de avance de las capacidades.
Contamos con numerosas líneas de evidencia sobre la contribución de la IA al progreso en distintas partes del proceso de entrenamiento de modelos. Estas incluyen entrevistas, mejoras autodeclaradas de rendimiento, número de empleados, líneas de código, uso en experimentos y reflexiones cualitativas del equipo directivo. Destacamos tres fuentes importantes que no fueron suprimidas.
En primer lugar, tanto METR como Anthropic entrevistaron detalladamente a numerosos investigadores sobre el grado de aceleración global, en su área de trabajo, atribuible al uso de IA (consulte los detalles en el apéndice más adelante). Nuestra impresión general fue un rango bastante amplio de estimaciones, pero centrado alrededor de una aceleración de 2 veces. En el apéndice se incluyen algunas citas, con los detalles confidenciales suprimidos.
En segundo lugar, Anthropic también compartió datos, procedentes de diversas fuentes, sobre la mejora en el rendimiento atribuida a la IA, según la propia percepción de los usuarios. Los datos más recientes proceden de una serie de encuestas en Slack, en las que el personal usa reacciones para indicar cuánto consideran que ha aumentado la velocidad obtenida con el modelo más reciente disponible en ese momento. Consideramos que esta evidencia es poco concluyente, ya que las respuestas reflejan valoraciones de bajo esfuerzo. No obstante, observamos un crecimiento constante en estas autoevaluaciones, que alcanzaron niveles muy elevados (hasta 12 veces mayor en octubre de 2026), tal como se muestra en el siguiente gráfico.
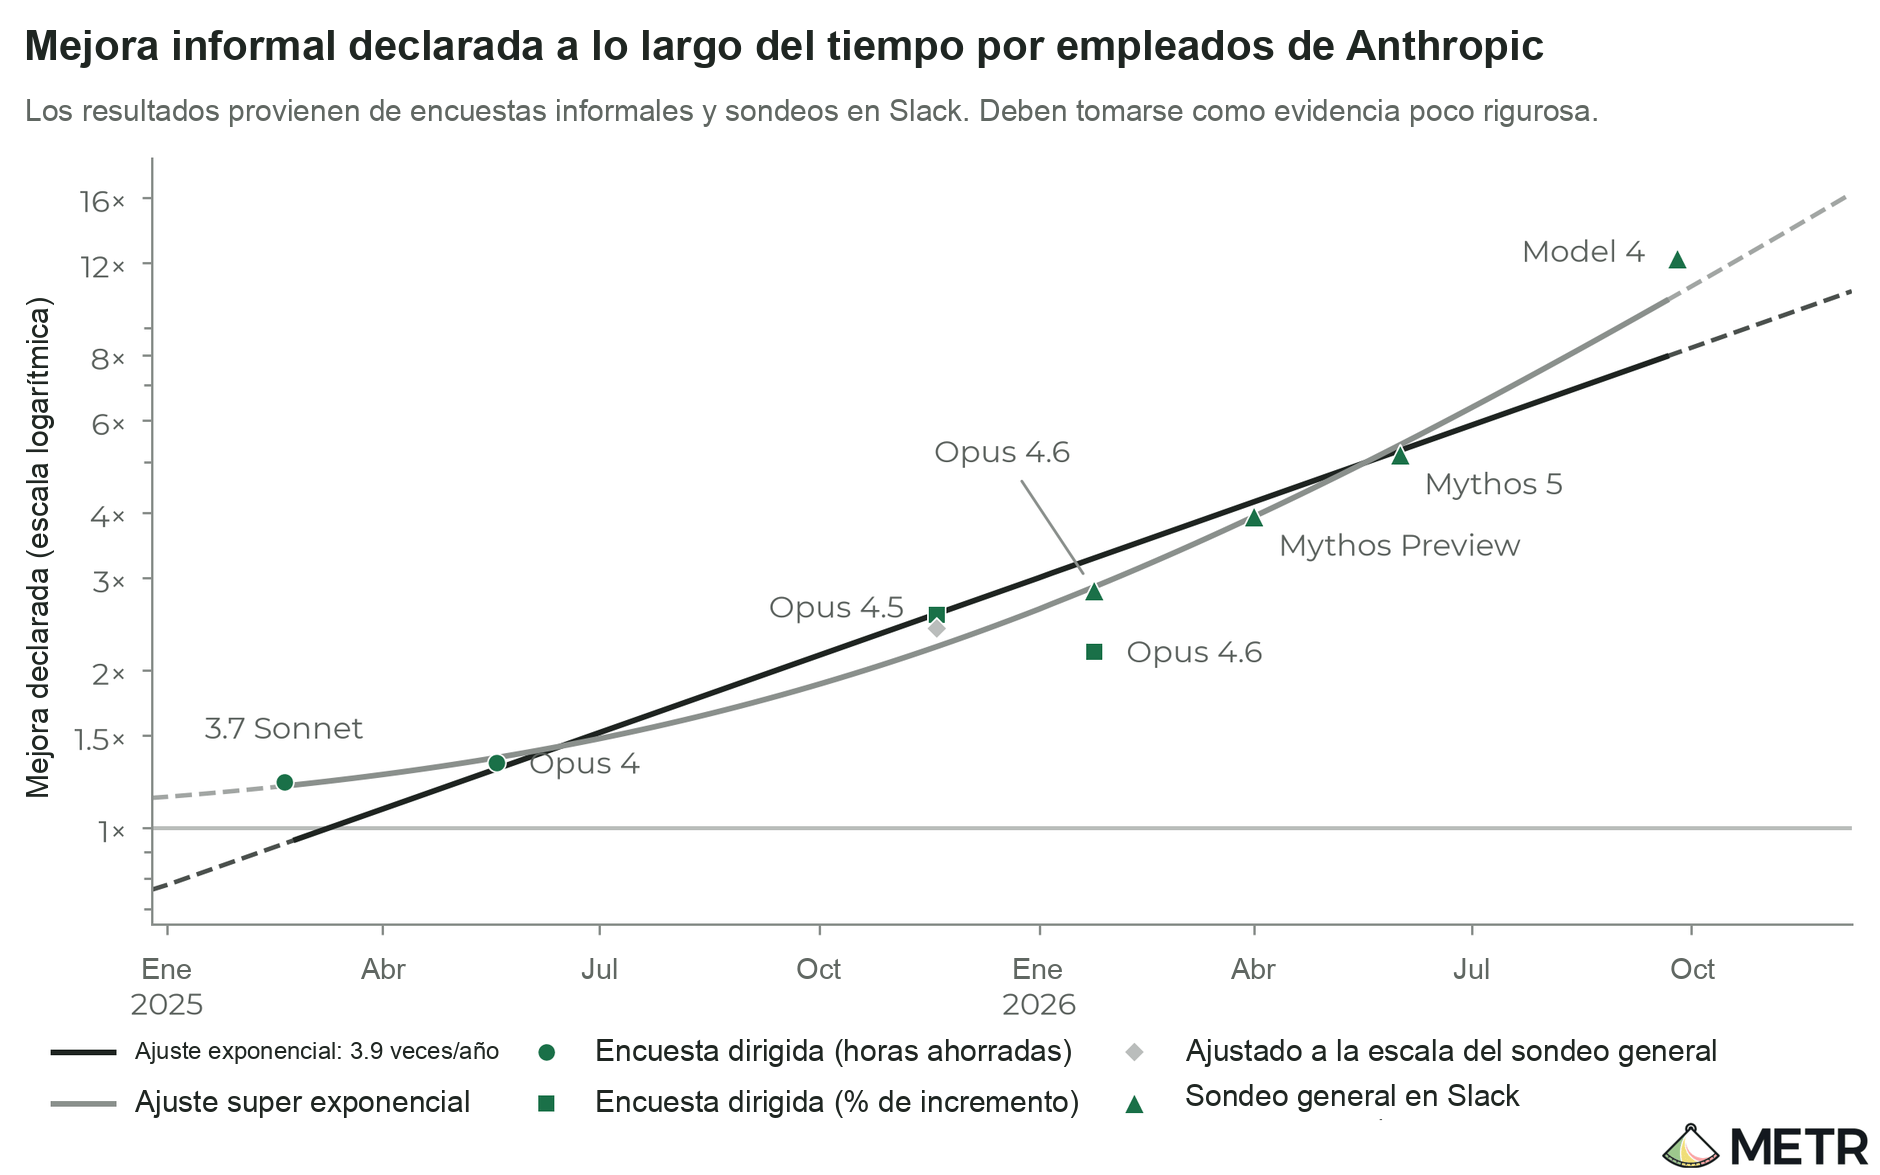
Cabe señalar que las estimaciones de mejora o aceleración individual no equivalen a tasas de aceleración general. Mantener una tasa de crecimiento determinada en los resultados, como las capacidades de un modelo, suele requerir un crecimiento igualmente sostenido en las entradas, como el trabajo humano y/o la productividad laboral, para contrarrestar los rendimientos decrecientes. Lograr una aceleración significativa en la tasa general de progreso suele requerir una aceleración considerable de dichas entradas. Por tanto, lo que más nos interesa es observar un cambio importante en la tasa de crecimiento de la mejora individual, más que su nivel absoluto. Nuestro análisis más detallado sobre qué tasa de crecimiento en la mejora individual podría ser necesaria para explicar las tasas de aceleración que hemos estimado en áreas clave fue suprimido.
En tercer lugar, entendemos que la IA todavía no es capaz de realizar contribuciones altamente significativas y totalmente autónomas en las partes más importantes del proceso de entrenamiento de modelos. Sin embargo, los investigadores describieron importantes “señales de vida” que indican que tales contribuciones podrían darse pronto, si bien con un grado de madurez que varía considerablemente según el área.
No identificamos cuellos de botella convincentes que frenen la continuidad de un avance rápido.
No encontramos evidencia de cuellos de botella significativos, ya sea en el progreso algorítmico, la capacidad de cómputo para el entrenamiento, la capacidad de cómputo para la experimentación o los datos, que vayan a manifestarse en los próximos 12 meses. Sin embargo, nuestra comprensión del estado de los distintos cuellos de botella cambió varias veces a medida que obtuvimos información más detallada, por lo que no tenemos confianza en nuestra evaluación actual. Anthropic suprimió nuestro análisis de varios cuellos de botella específicos.
La evidencia adicional suprimida, a veces difícil de interpretar, respalda una aceleración sostenida y potencialmente creciente.
Investigamos diversas métricas y metodologías internas para medir la aceleración en áreas clave del proceso de entrenamiento de modelos. Esto incluyó evidencia del avance en pruebas de referencia (benchmarks) y en métricas de eficiencia algorítmica y de solidez general de los modelos, tanto en el preentrenamiento como en el aprendizaje por refuerzo (RL), así como mejoras en la utilización del cómputo, la eficiencia de la inferencia y la eficiencia en el uso de datos. Estas investigaciones incluyeron intentos por comprender:
- Las distintas variantes metodológicas de las métricas internas. Dedicamos varias semanas a estas investigaciones y esta es nuestra mayor fuente de incertidumbre.
- Las creencias del personal de los equipos pertinentes sobre la evidencia interna clave y las estimaciones de la aceleración.
- Si otras partes del proceso de entrenamiento de modelos podrían estar sesgando nuestras estimaciones de aceleración y dónde se podrían aplicar ajustes.
- Si es posible que Anthropic esté sobreajustando respecto a métricas internas.
Esta evidencia interna respaldó la existencia de una aceleración significativa en el proceso de entrenamiento de modelos de Anthropic. Algunos de estos indicios sugerían que dicha aceleración podría superar un factor del doble e incrementarse con el paso del tiempo; no obstante, existen incertidumbres considerables en cuanto a su interpretación.
Detalles del proceso
El personal de METR evaluó en qué medida la IA está acelerando la I+D en IA en Anthropic.
El personal de METR4 (equivalente a 2.5 empleados de tiempo completo) realizó, a modo de piloto, una evaluación de alto acceso en Anthropic para determinar en qué medida la IA está acelerando la I+D en IA y con qué rapidez podrían surgir capacidades extremas y riesgosas en el futuro cercano.
Anthropic incluye la aceleración de la I+D en IA como un indicador clave de riesgo en su Política de escalamiento responsable (RSP, por sus siglas en inglés). En esta evaluación no prestamos atención especial a los umbrales establecidos en la RSP. En cambio, tratamos de ofrecer una visión integral de cómo la IA impulsa la aceleración de la propia I+D en IA.
Esta colaboración comenzó a mediados de agosto y es distinta de la evaluación anunciada por Anthropic el 15 de octubre.
Detalles de la colaboración.
El personal de METR trabajó durante once semanas para evaluar de manera independiente en qué medida la IA está acelerando la I+D en IA en Anthropic. Nuestra evaluación se centró en tres preguntas generales:
- ¿Se ha acelerado la tasa de crecimiento de las capacidades internas de Anthropic?
- ¿Qué porción de dicha aceleración, en caso de haberla, es atribuible a la IA?
- ¿Existen cuellos de botella importantes que podrían ralentizar el crecimiento o limitar la aceleración a corto plazo?
Además, se nos encargó revisar la sección sobre I+D en IA del informe de riesgos de Anthropic de agosto de 2026, que estamos publicando por separado. Como describimos más adelante, el alcance de la evaluación contratada inicialmente incluía verificar qué porcentaje del cómputo se asignaba a capacidades comparado al asignado a la seguridad.
METR tenía la facultad de solicitar acceso a cualquier información que considerara pertinente para comprender la aceleración de la I+D en IA, y Anthropic podía aprobar o rechazar nuestras solicitudes de manera unilateral. En la práctica, con frecuencia negociamos con el personal de Anthropic y llegamos a acuerdos para obtener datos que fueran informativos, no extremadamente sensibles y fáciles de compartir. Más adelante damos más detalles sobre lo que Anthropic compartió y sobre lo que se negó a compartir, y señalamos que, en términos generales, el acceso otorgado superó nuestras expectativas. Para esta colaboración, no solicitamos ni recibimos acceso para generar muestras a partir de modelos que no son de acceso público.
Cabe aclarar que ni METR ni Anthropic pretendían que este proyecto implicara un acceso pleno “equiparable al de un empleado,” es decir, un acceso directo a datos, documentos o modelos. En particular, este proyecto no es el descrito en la actualización de Anthropic del 15 de octubre sobre evaluadores independientes.
Anthropic tenía derechos unilaterales de supresión sobre toda la información no pública de este informe. Nosotros teníamos el derecho unilateral de divulgar:
- la existencia y los términos generales del proceso de revisión y supresión,
- si Anthropic ejerció sus derechos de supresión,
- si alguno de los hallazgos dependía significativamente o no de la información suprimida,
- el nivel de acceso que se nos otorgó.
Por razones de seguridad, trabajamos en dispositivos de Anthropic durante todo el periodo de esta evaluación. Anthropic proporcionó tokens sin costo para esta evaluación, que utilizamos principalmente para el análisis y la visualización de datos con asistencia de IA. De acuerdo con nuestro procedimiento habitual, no recibimos ningún pago por parte de Anthropic.
Este ejercicio se llevó a cabo conforme a las políticas de METR para la colaboración con empresas de IA. Incluimos una declaración de conflictos de interés (COI, por sus siglas en inglés) y extractos del lenguaje contractual en el apéndice de divulgaciones sobre la transparencia del proceso, así como la lista de verificación AEF-1.
Detalles de las supresiones realizadas por Anthropic.
Nuestro informe completo, de aproximadamente 100 páginas, intenta responder en detalle las preguntas clave que recientemente describimos como cruciales para las futuras evaluaciones de I+D en IA. En la siguiente tabla resumimos las fuentes de evidencia que se nos proporcionaron y cuáles pudimos incluir en este informe público.
Tabla de fuentes de evidencia compartidas y suprimidas
| Tipo de información | ¿Se compartió con METR? | ¿Se describen los resultados en el informe público? |
|---|---|---|
| Mediciones de las capacidades internas: capacidades en pruebas de referencia (benchmarks) de los modelos internos | Sí | Sí |
| Mediciones de las capacidades internas: medidas intermedias clave | Sí | No |
| Estimaciones del progreso algorítmico | Sí | No |
| Evidencia de la contribución de la IA | Sí | Parcialmente |
| Mediciones de entradas clave de la I+D | En su mayoría | No |
| Detalles de cuellos de botella y pronósticos | Parcialmente | No |
| Entrevistas con el personal | Sí | Parcialmente |
Las supresiones de Anthropic también implicaron que no pudiéramos comunicar:
- Nuestras estimaciones más detalladas de la aceleración y de la contribución atribuible al uso de IA en áreas clave del proceso de entrenamiento de modelos.
- Nuestro desglose más detallado del progreso atribuible al cómputo, los datos y el progreso algorítmico, más allá de la conclusión principal de que “confiamos en que la aceleración no se debió a una aceleración en el cómputo para entrenamiento.”
- Respuestas más detalladas a las preguntas sobre limitaciones incluidas en nuestra propuesta, lo cual habría requerido una mayor discusión de los detalles metodológicos.
- Los pronósticos de métricas para modelos futuros.
También realizaron otras supresiones menores a lo largo del informe, que procuramos describir en cada sección.
Anthropic describió las supresiones como medidas “orientadas a eliminar información confidencial que podría acelerar a otros desarrolladores de IA.”
Fechas clave.
- 12 de agosto: Anthropic comienza a compartir información confidencial con METR.
- 14 de agosto: Anthropic comparte con METR la versión sin supresiones de su informe de riesgos de agosto sobre I+D en IA.
- 12 de septiembre: METR entrega a Anthropic un primer borrador de su informe completo para recibir retroalimentación.
- 18 de septiembre: METR entrega a Anthropic un primer borrador de su revisión del informe de riesgos para recibir retroalimentación.
- 22 de septiembre al 22 de octubre: METR realiza iteraciones en la revisión del informe de riesgos y en el informe completo, incorporando información adicional.
- 22 de octubre: METR entrega a Anthropic su informe completo de aproximadamente 100 páginas.
- 25 de octubre: Anthropic comparte los lineamientos para las supresiones, resumidos anteriormente.
- 26 de octubre: METR entrega a Anthropic un borrador de este informe público.
- 27 al 29 de octubre: Anthropic hace más estrictos los lineamientos para las supresiones y METR realiza nuevas revisiones del informe público como resultado.
- 29 de octubre: METR presenta un borrador del informe público.
- 29 de octubre: Anthropic y METR acuerdan una prórroga de aproximadamente cinco días para poder atender con mayor cuidado los nuevos lineamientos para las supresiones.
- 3 de noviembre: METR presenta la versión final del informe público.
METR recibió una cantidad considerable de datos privados de Anthropic.
METR hizo solicitudes exhaustivas de información sobre cada parte del proceso de I+D en IA, y Anthropic compartió más información de la que se había contemplado inicialmente para este proyecto, superando nuestras expectativas. Por lo general, la información se compartía pocos días después de haberla solicitado.
Una descripción detallada de los datos a los que tuvimos acceso fue suprimida. A continuación se presenta una versión resumida:
- Puntajes en pruebas de referencia (benchmarks) internas y AECI de los modelos internos, además de tareas de muestra, respuestas de las rúbricas y gasto de los agentes en dichas tareas.
- Datos históricos sobre eficiencia algorítmica y solidez general de los modelos en preentrenamiento y aprendizaje por refuerzo (RL), así como mejoras en la utilización del cómputo, la eficiencia de la inferencia y la eficiencia en el uso de datos.
- Número de empleados y atribución del progreso a miembros específicos del personal.
- Métricas del cómputo para entrenamiento en numerosas áreas relevantes.
- Análisis internos sobre preguntas abiertas relevantes.
- Encuestas internas sobre la mejora del rendimiento mediante el uso de IA, según lo reportado por los propios equipos.
- Líneas de código y solicitudes de incorporación de cambios (pull requests) en toda la empresa y en algunos equipos de investigación.
- Gasto en inferencia de los agentes de IA a lo largo del tiempo.
- Documentos internos sobre contribuciones autónomas a la investigación.
- Aproximadamente 15 entrevistas con miembros clave del personal, que abarcaron un alcance predefinido pero amplio, del cual se excluyeron temas especialmente sensibles.
En un número reducido de casos, Anthropic no proporcionó información pertinente por considerar que era demasiado sensible.
Anthropic también destinó una cantidad considerable de tiempo y experiencia de su personal a este proyecto. Consideramos que los dos miembros del personal con quienes trabajamos más estrechamente son los investigadores de Anthropic con mayor conocimiento y contexto sobre la medición de la aceleración de la I+D en IA. Ambos se reunieron con nosotros frecuentemente para conversar en directo, y dedicaron una cantidad sustancial de tiempo a recopilar datos, realizar análisis y darnos retroalimentación.
Anthropic canceló un componente de asignación de capacidad de cómputo de esta evaluación.
El alcance contratado de este proyecto incluía originalmente una verificación de la asignación de cómputo de Anthropic, en especial de la distribución entre capacidades y seguridad. Sin embargo, a mitad del proyecto, Anthropic modificó el alcance de este proyecto para excluir la verificación del cómputo y centrarse únicamente en la aceleración de la I+D en IA. Este componente se canceló antes de que METR llegara a conclusiones sustanciales sobre el uso de la capacidad de cómputo en Anthropic. Anthropic señaló que esto se debió al deseo de mantener el enfoque de la colaboración en la evaluación de riesgos por el momento, y que retomaría posteriormente la verificación de la asignación de los recursos de computación.
Limitaciones
Presentamos nuestras mejores conjeturas sobre las formas en que podríamos estar interpretando incorrectamente la evidencia.
Analizamos las principales maneras en que podríamos estar cometiendo errores en nuestra interpretación de la evidencia. Destacamos:
- Las limitaciones derivadas de la estructura de esta evaluación.
- Las limitaciones derivadas de un análisis incorrecto.
Un acceso limitado pudo habernos llevado a pasar por alto contexto o datos importantes.
A pesar del acceso otorgado a METR, está claro que contar con un acceso equivalente al del personal de Anthropic permitiría una evaluación significativamente más profunda. El flujo de información del que dispusimos fue relativamente limitado y se rechazó un pequeño número de nuestras solicitudes de datos. Poder consultar documentos cuando fuera necesario, observar debates y conversaciones internas, y sostener conversaciones frecuentes y diversas nos habría permitido obtener una visión más completa. Aunque creemos haber tenido acceso a la mayor parte de la información relevante, es posible que hayamos pasado por alto información importante porque desconocíamos su existencia o no pudimos buscarla por nuestra cuenta.
Durante el transcurso de nuestro trabajo, cambiamos de manera sustancial nuestra interpretación de datos clave a medida que se nos compartía más contexto. En algunos casos, esto nos llevó a cambiar de postura varias veces sobre cuestiones críticas. Creemos que un acceso más amplio habría acelerado drásticamente ese proceso de interpretación adecuada, y consideramos probable que aún existan puntos que podríamos haber interpretado incorrectamente por falta de contexto suficiente.
La aceleración podría ser mayor de lo que estima este informe.
Nuestras mejores hipótesis sobre cómo podríamos estar subestimando la aceleración son las siguientes:
- Es posible que hayamos pasado por alto una aceleración adicional reciente. La tasa de crecimiento podría estar experimentando una aceleración continua, por ejemplo, un crecimiento hiperbólico. Aunque no observamos evidencia clara de ello en las tendencias del AECI, existe otra evidencia, suprimida por Anthropic, que lo hace parecer más plausible. Si el crecimiento es hiperbólico, probablemente estemos subestimando la aceleración instantánea y minimizando de manera sustancial la aceleración en el futuro cercano. Además, solo observamos los resultados a nivel de modelo una vez que este ha sido entrenado, y esto significa que observamos la aceleración en la I+D efectiva con un desfase aproximadamente igual al tiempo de entrenamiento del modelo.
- La automatización podría estar más cerca de lo que estimamos. Entendemos que la IA todavía no puede automatizar por completo partes sustanciales del proceso de entrenamiento de modelos de Anthropic. Sin embargo, existen “señales de vida” que se analizan más adelante. Es posible que la automatización esté cerca y que, una vez eliminados los cuellos de botella humanos, dé lugar a una aceleración muy rápida.
- El AECI podría subestimar el impacto de las capacidades en el mundo real. Contamos con datos escasos sobre la relación entre los puntajes en pruebas de referencia (benchmarks) y el impacto en el mundo real. Como ejemplo, los puntajes del ECI en matemáticas no se han acelerado de manera sustancial, pero hoy estamos viendo la resolución de problemas del milenio que han eludido décadas de esfuerzo humano. Los impactos en el mundo real podrían derivarse de umbrales de capacidad que los modelos superan de forma repentina, lo que daría lugar a impactos abruptos que son difíciles de predecir.
La aceleración podría ser menor de lo que estima este informe.
Nuestras mejores hipótesis sobre cómo podríamos estar sobreestimando la aceleración son:
- Los factores ajenos a la IA podrían explicar la mayor parte de la aceleración. Es posible que los factores ajenos a la IA expliquen toda la aceleración reciente o la mayor parte. Esto implicaría que tenemos menos razones para esperar un alto crecimiento futuro o aceleraciones futuras.
- La aceleración podría limitarse a tareas bien delimitadas. Gran parte de la evidencia que examinamos mide el desempeño en tareas bien delimitadas, cuyos resultados son fáciles de evaluar automáticamente o mediante un modelo de lenguaje. Si los modelos recientes han estado creciendo más rápido en tareas “limpias” que en tareas “desordenadas” (en relación con las tasas de crecimiento relativas históricas), podríamos estar sobreestimando la aceleración del impacto en el mundo real. Por ejemplo, es posible que los avances recientes se estén sobreajustando a los tipos de tareas que se incluyen en el AECI.
- Nuestras cifras de aceleración podrían estar sobreestimadas si la tasa histórica de crecimiento fue inusualmente baja. Si el progreso histórico estuvo por debajo de su tasa normal o natural debido a factores temporales, esto podría llevarnos a sobreestimar la magnitud de la aceleración. Como describimos en un apéndice, antes de finales de 2025 los modelos de Anthropic tuvieron una tasa histórica de crecimiento en el AECI inferior a la de los modelos de frontera de la industria en su conjunto, lo que podría explicar parte de la aceleración.
Apéndices
Metodología
Supresiones en esta sección.
Ninguna parte de esta sección fue suprimida; no obstante, cabe señalar que algunos de los aspectos metodológicos podrían aplicarse únicamente al informe completo.
Incluimos datos de modelos de uso exclusivamente interno de Anthropic.
Esto incluye los siguientes modelos (estos son los nombres clave que se nos compartieron; entendemos que internamente tienen otros nombres clave):
- Unreleased 2022, cuyo entrenamiento concluyó en 2022
- Model 2, cuyo entrenamiento concluyó en julio de 2026
- Model 3, cuyo entrenamiento concluyó entre agosto y septiembre de 2026
- Model 4, cuyo entrenamiento concluyó entre septiembre y octubre de 2026
El informe completo de METR incluye un pronóstico para un modelo futuro, pero esta información fue suprimida.
Usamos ajustes lineales por tramos (piecewise linear fits) para detectar la aceleración.
Por lo general, estimamos las tendencias temporales mediante un ajuste por mínimos cuadrados ordinarios con un único punto de interrupción (breakpoint) estimado; luego reportamos la aceleración como la proporción entre las dos tendencias lineales estimadas. Adoptamos el punto de quiebre de mejor ajuste en los datos estándar del AECI como punto de quiebre predeterminado en los demás gráficos, con el fin de contar con un punto de quiebre uniforme en todo este informe. Sin embargo, en algunos casos contemplamos desviaciones respecto a este criterio y evaluamos la aceleración estimada según el mejor ajuste de cada gráfico.
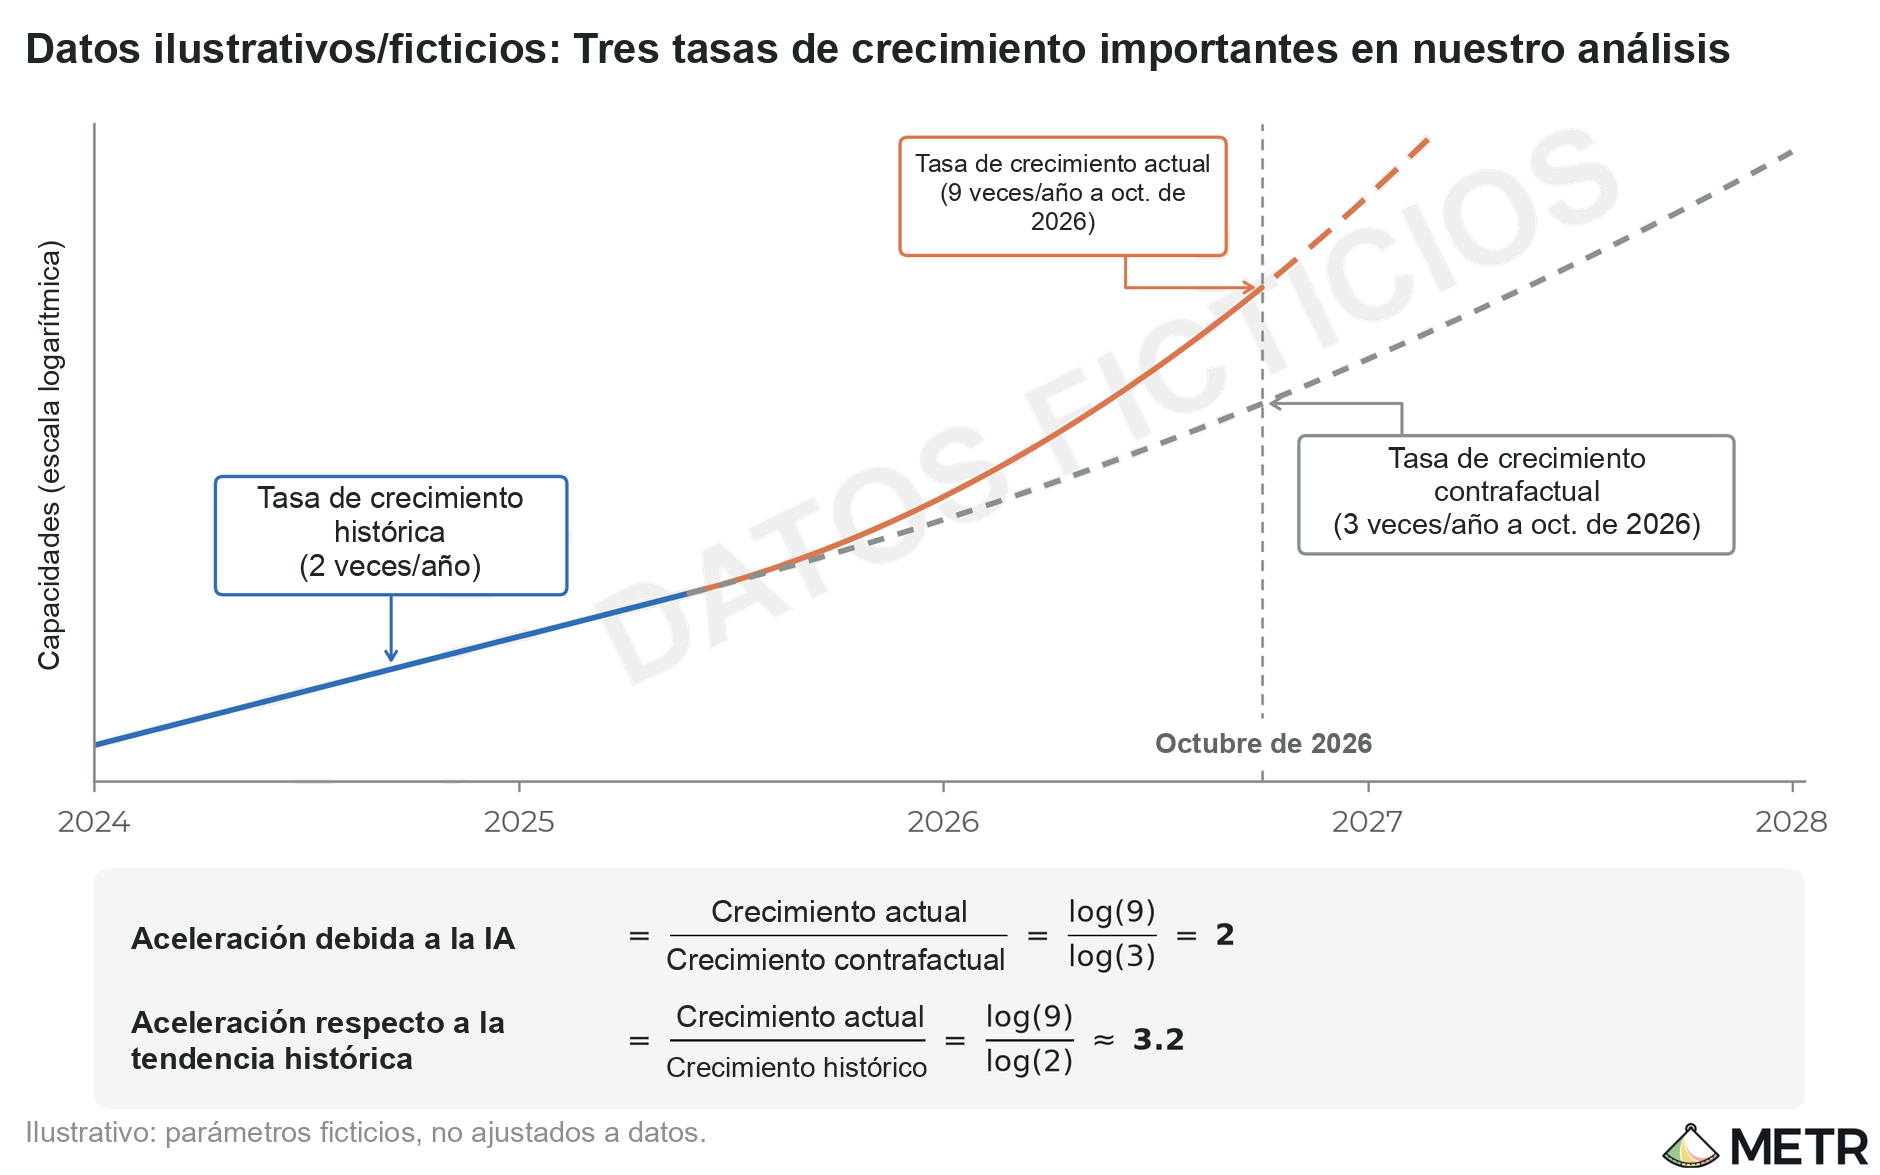
Organizamos nuestro análisis en torno a 3 tasas de crecimiento: la tasa de crecimiento histórica, la actual y la contrafactual.
Nuestro objetivo es evaluar en qué medida la automatización mediante IA está acelerando el progreso de la IA. Para cualquier medida de progreso (por ejemplo, las capacidades de los modelos medidas con el AECI), podemos estimar tres valores:
- Tasa de crecimiento histórica: la tasa de crecimiento previo a un cambio de tendencia detectado.
- Tasa de crecimiento actual: la tasa de crecimiento a octubre de 2026.
- Tasa de crecimiento contrafactual: la tasa de crecimiento a octubre de 2026 si Anthropic no hubiera podido usar IA.
Las dos primeras son cantidades observables. La tasa de crecimiento contrafactual solo podemos estimarla por conjetura. El siguiente gráfico ilustra estas medidas a partir de datos de ejemplo:
Es importante distinguir entre la aceleración instantánea debida a la IA, tal como la hemos definido, y la aceleración acumulada debida a la IA, es decir, qué fracción del progreso total desde cierto momento (por ejemplo, octubre de 2025) puede atribuirse a la IA. Algunas entrevistas y documentos abordan, de forma implícita o explícita, la aceleración acumulada, aunque en general esperamos que esta sea menor que la aceleración instantánea, debido a los factores de aceleración ajenos a la IA en 2025 y a la creciente influencia de la IA a lo largo del tiempo.
En el informe completo, organizamos la evidencia indirecta con un sencillo marco contable.
Queremos comprender si se ha producido una aceleración en las capacidades generales como resultado de la I+D en IA. Para llegar a nuestras conclusiones subjetivas, organizamos nuestra evidencia usando el siguiente marco contable, aunque se suprimieron todas las referencias pertinentes a su aplicación.
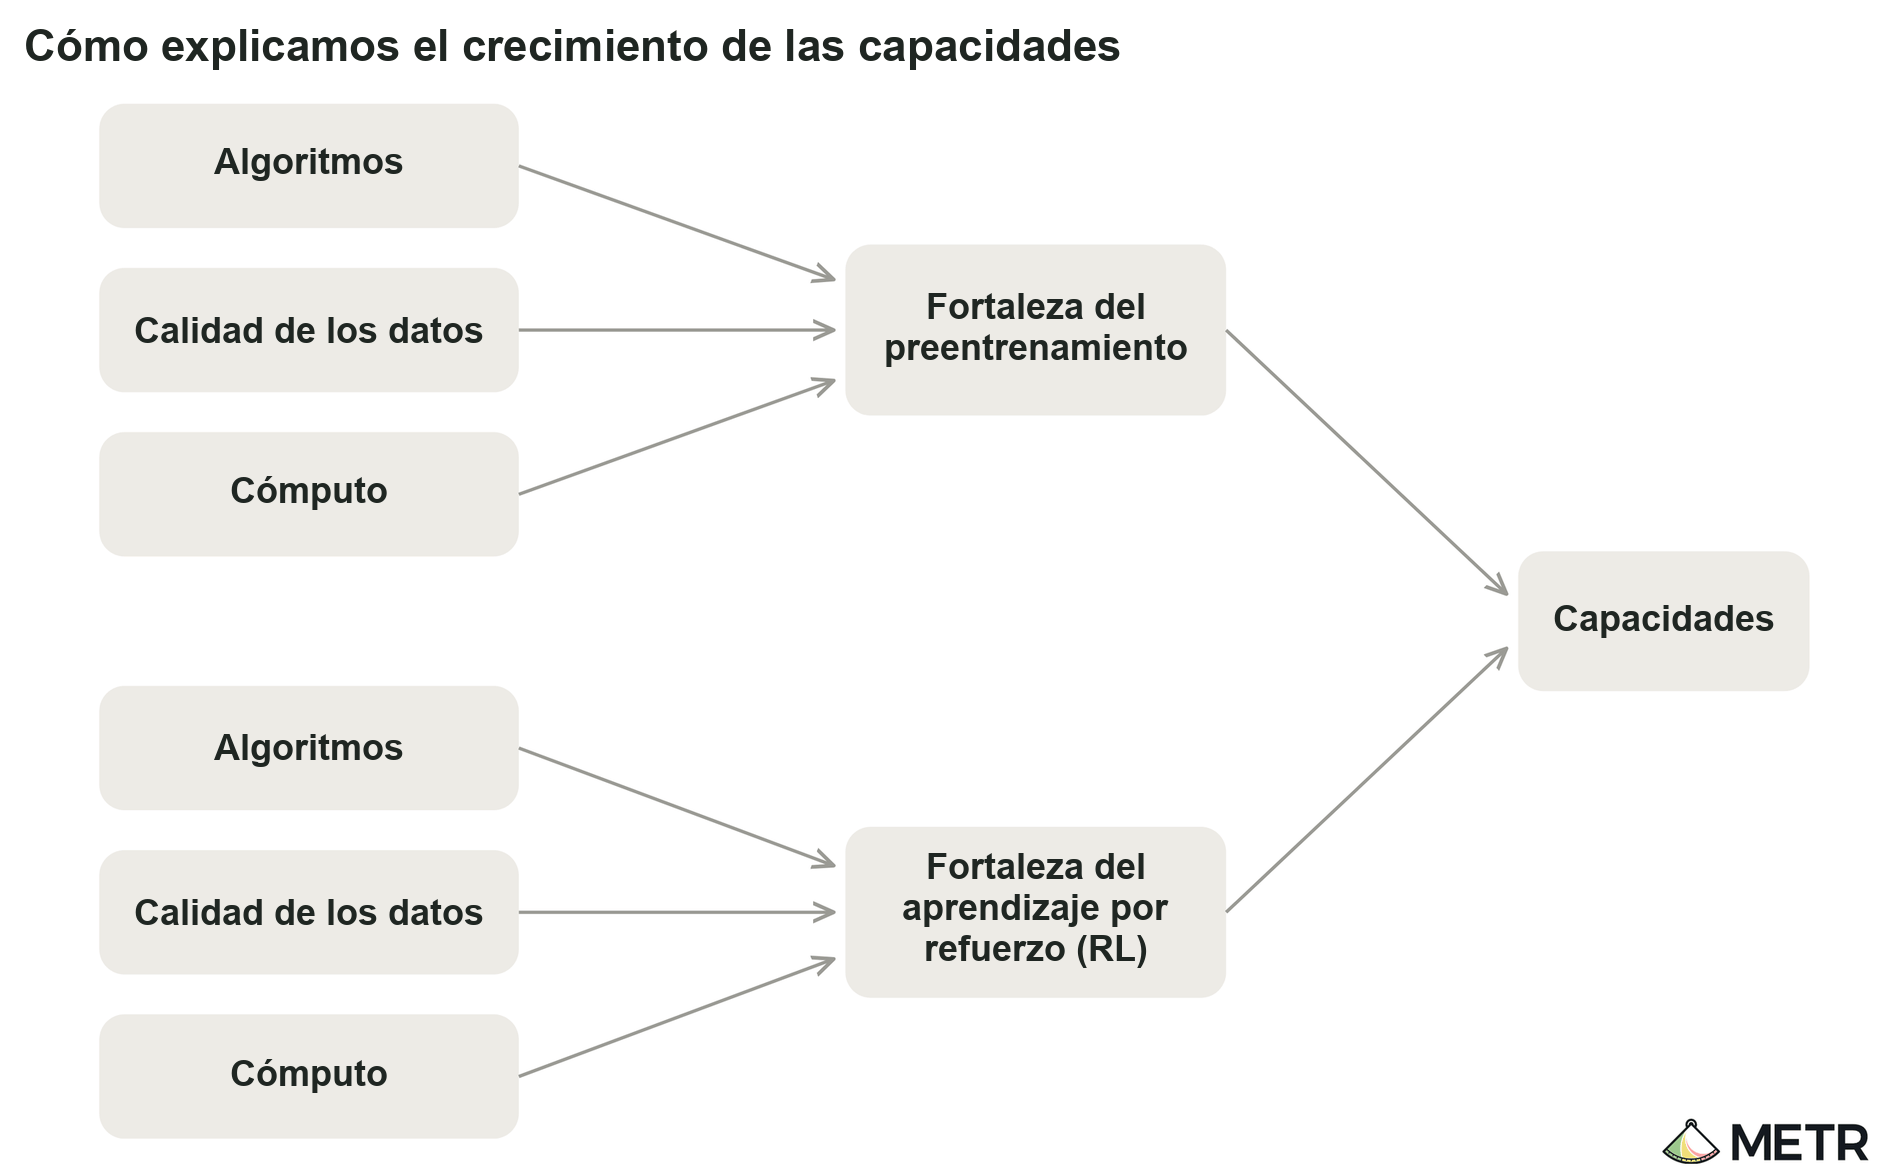
Las flechas que llegan a un recuadro indican que este es función de los recuadros precedentes. Por ejemplo, la solidez del preentrenamiento depende de los algoritmos, la calidad de los datos y el cómputo de entrenamiento. Usamos el término RL, aprendizaje por refuerzo en español, para abarcar todas las contribuciones no incluidas en el preentrenamiento.
Este marco nos permite partir de la derecha (capacidades) y determinar si ha habido una aceleración. Luego podemos retroceder un nivel para ver si ha habido una aceleración en el preentrenamiento o en el RL, y retroceder un nivel más para identificar qué entradas están causando esa aceleración. Esto nos permite comprender con mayor profundidad lo que ocurre con las entradas.
En el informe completo, todos los análisis se documentaron en un cuaderno interactivo (notebook) y un tablero de control (dashboard) complementarios.
Para garantizar la reproducibilidad, mantuvimos un cuaderno interactivo y un tablero de control con todos los resultados del informe completo. Cuando fue viable, incluimos referencias al cuaderno o al tablero, y la mayoría de los gráficos llevaban un “sello” que identificaba su procedencia.
Puntajes en pruebas de referencia (AECI)
Descripción general del apéndice sobre el AECI.
Ampliamos el análisis principal del AECI de varias maneras:
- Explicamos la metodología detrás de nuestra estimación principal de una aceleración de 1.9 veces en el AECI.
- Mostramos que el grado de aceleración estimado varía en función de opciones de análisis alternativas razonables:
- Variación de la función de enlace: 1.1–2.9 veces.
- Variación de las capturas (snapshots) usadas: 1.9–2.2 veces.
- Variación de las pruebas de referencia (benchmarks) usadas: 1.9–2.2 veces.
- Variar el regularizador (regularizer) usado: 1.9–2.1 veces.
- Explicamos por qué estos resultados difieren de las estimaciones del AECI en las fichas de sistema (system cards) anteriores de Anthropic.
- Analizamos detalladamente los posibles problemas del índice AECI, tales como:
- Las pruebas de referencia (benchmarks) internas de Anthropic presentan niveles de saturación cada vez mayores: Model 4 obtiene más del 50% en todas las pruebas de referencia del AECI en las que fue evaluado. Sin embargo, la aceleración medida parece ser razonablemente robusta frente a las preocupaciones por saturación.
- El gasto en tokens podría ser demasiado bajo para aprovechar al máximo el rendimiento posible de los modelos.
- La función de enlace logística podría estar mal especificada en algunas pruebas de referencia. Sin embargo, en términos generales, consideramos que es una aproximación razonable.
- Hay diversas razones por las que una aceleración en los puntajes de las pruebas de referencia podría sobrestimar o subestimar una aceleración en los impactos en el mundo real.
Supresiones en esta sección.
Anthropic realizó muy pocas supresiones en esta sección. La única información suprimida fue:
- Los nombres de pruebas de referencia (benchmarks) específicas.
- Un gráfico que muestra los resultados del AECI para un subconjunto de modelos seleccionados a partir de información que fue suprimida.
Detalles metodológicos sobre la estimación del AECI.
Usamos el código público de Epoch para estimar los valores del AECI de cada modelo. Generamos intervalos de confianza del 95% mediante bootstrap, extrayendo puntuaciones de las pruebas de referencia (benchmarks) con reemplazo y con estratificación por modelo.
Nuestros datos subyacientes incluyen los puntajes del AECI de numerosas capturas (snapshots) por modelo. Estas capturas difieren tanto en las fechas como en los puntajes del AECI.
Para los modelos lanzados públicamente, incluimos la captura que se lanzó al público y la fecha en que esa captura estuvo disponible para la mayoría de los empleados de Anthropic. Por ejemplo, si un modelo tiene dos capturas: una disponible para los empleados de Anthropic el 10 de noviembre y otra disponible para ellos el 20 de noviembre, y la segunda se lanzó públicamente el 1 de diciembre, nuestro procedimiento asignaría el 20 de noviembre como fecha de lanzamiento. Consideramos que existen muchos procedimientos alternativos razonables para asignar fechas (por ejemplo, usar la fecha de lanzamiento de la primera captura en lugar de la última), los cuales se muestran más adelante en uno de los ejercicios de robustez.
En el caso de los modelos que nunca son lanzados, incluimos las capturas que recibieron un uso interno considerable y la fecha en que la mayoría de los empleados de Anthropic pudo utilizarlas.
Usamos la fecha en que la mayoría de los empleados de Anthropic pudo utilizar el modelo, en lugar de las fechas de lanzamiento público; esto nos permite hacer comparaciones equitativas con los modelos no lanzados. En general, esto arroja grados de aceleración ligeramente mayores, ya que Anthropic retiene los modelos más recientes por un periodo un poco más largo antes de su lanzamiento público.
Al ajustar las tendencias a lo largo del tiempo, usamos mínimos cuadrados ordinarios, otorgando el mismo peso a cada captura que se encuentra en la frontera. El intervalo de confianza en la estimación de la tendencia solo contempla la incertidumbre en los puntajes del AECI de cada modelo, y no incluye la incertidumbre de muestreo sobre qué modelos se incluyen en el ajuste.
Estimamos un punto de quiebre en la tendencia, aunque imponemos de manera exógena la existencia de un único punto de quiebre. Estimamos que el punto de quiebre es el 7 de octubre de 2025 en nuestra especificación principal del AECI. En nuestras verificaciones de robustez, mantenemos este punto de interrupción del 7 de octubre de 2025 para asegurar la comparabilidad.
Robustez: las estimaciones de la aceleración del AECI varían entre 1.1 y 2.9 veces dependiendo de la función de enlace.
A continuación mostramos que las estimaciones de la aceleración del AECI son, en cierta medida, sensibles a los supuestos sobre la distribución de la dificultad de las tareas dentro de cada prueba de referencia (benchmark). En teoría, podríamos distinguir entre estos supuestos a partir de los datos, pero en la práctica la mayoría de las funciones se ajustan a los datos casi igual de bien. Agradecemos las sugerencias útiles del personal de Anthropic sobre el análisis en este punto.
El índice AECI asume que el puntaje de un modelo en una prueba de referencia es una función de la solidez latente del modelo y, en concreto, que dicha función es logística (se muestra más abajo en negro). Esto puede interpretarse como un supuesto sobre la distribución de la dificultad de las tareas en una prueba de referencia, incluida la cantidad de tareas defectuosas o la fracción que puede resolverse mediante adivinación. La siguiente figura ilustra algunas funciones de enlace distintas. La función logística supone una distribución simétrica con colas que decrecen de manera exponencial. La función log-log supone una cola larga de tareas difíciles; la función log-log complementaria supone una cola larga de tareas fáciles.
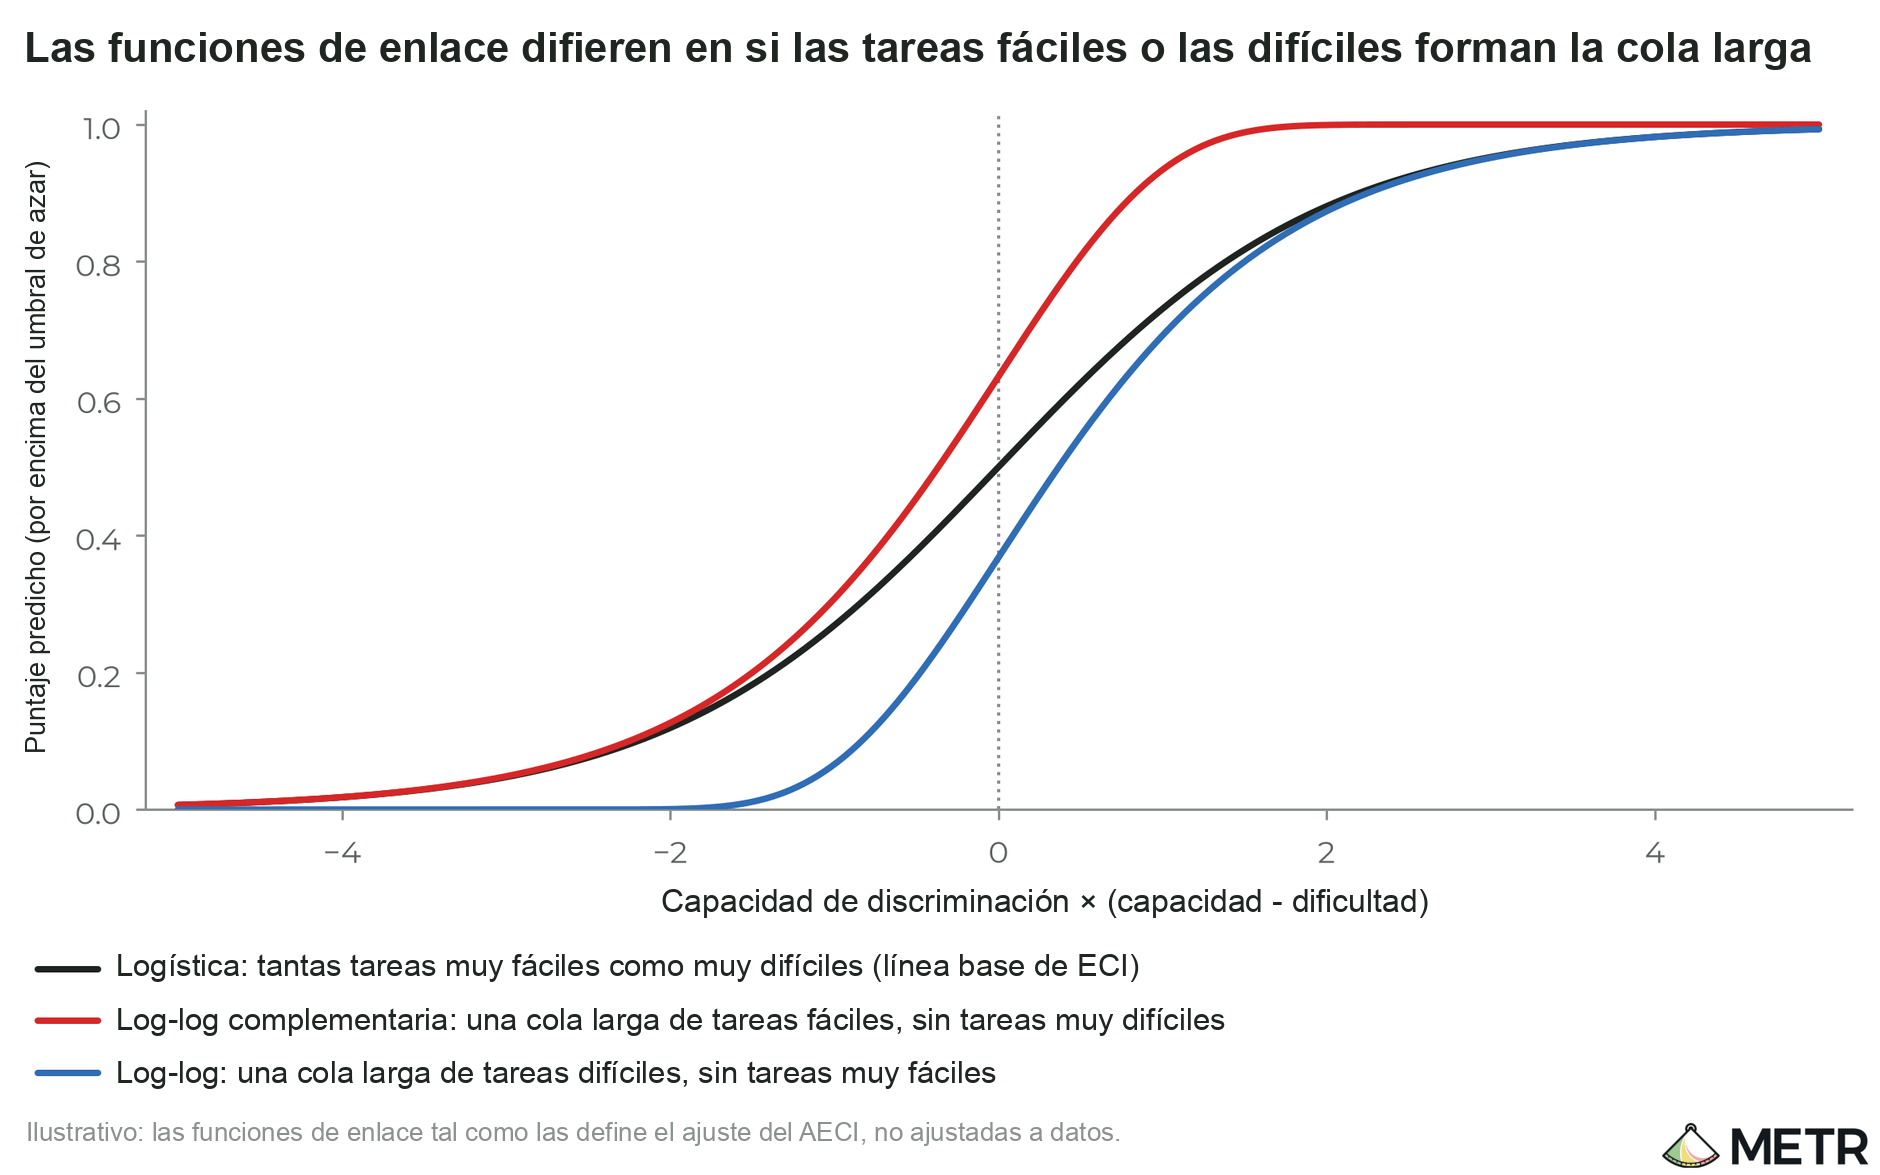
La siguiente tabla muestra la aceleración estimada según distintos supuestos sobre la función de enlace. Cabe señalar que todas estas funciones de enlace son globales, es decir, no son específicas de cada prueba de referencia.
| Función de enlace | Supuesto intuitivo sobre la distribución de las tareas | Aceleración | R² fuera de muestra | Figura |
|---|---|---|---|---|
| Logística estándar | Las pruebas de referencia (benchmarks) tienen una distribución simétrica de la dificultad de los problemas, con colas exponenciales. | 1.9 veces [1.5–2.8] | 87.2% | arriba |
| Probit | Las pruebas de referencia tienen una cola menor tanto de problemas fáciles como difíciles. | 1.8 veces [1.3–2.7] | 87.1% | 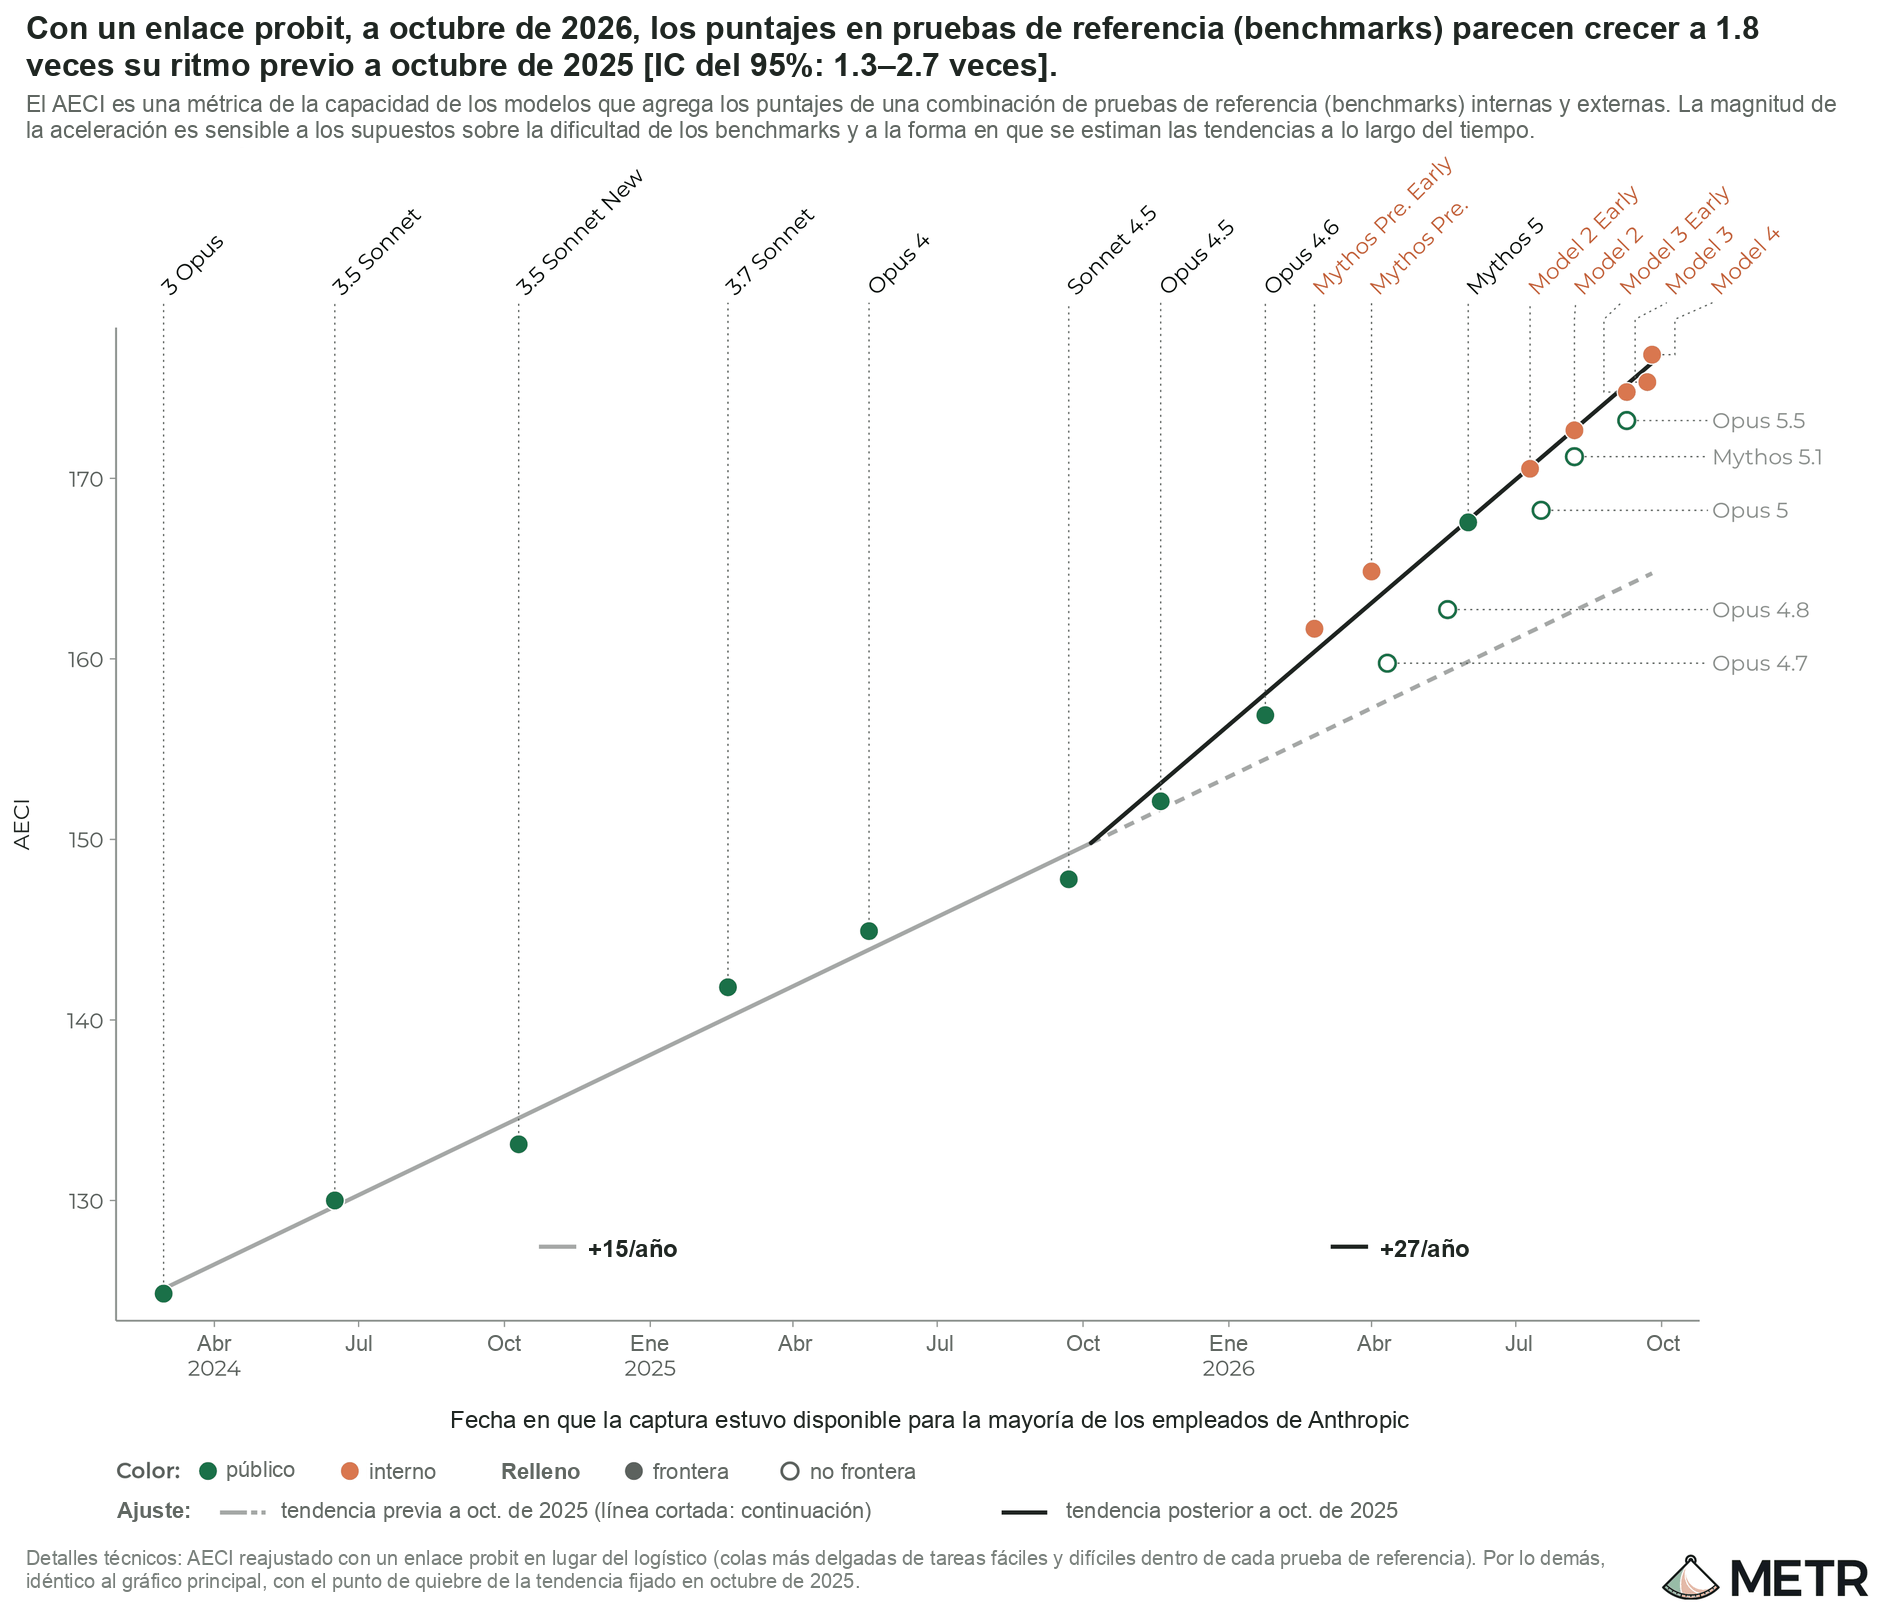 |
| Cauchit | Las pruebas de referencia tienen una cola mayor tanto de problemas fáciles como difíciles. | 2.8 veces [2.0–4.1] | 86.1% | 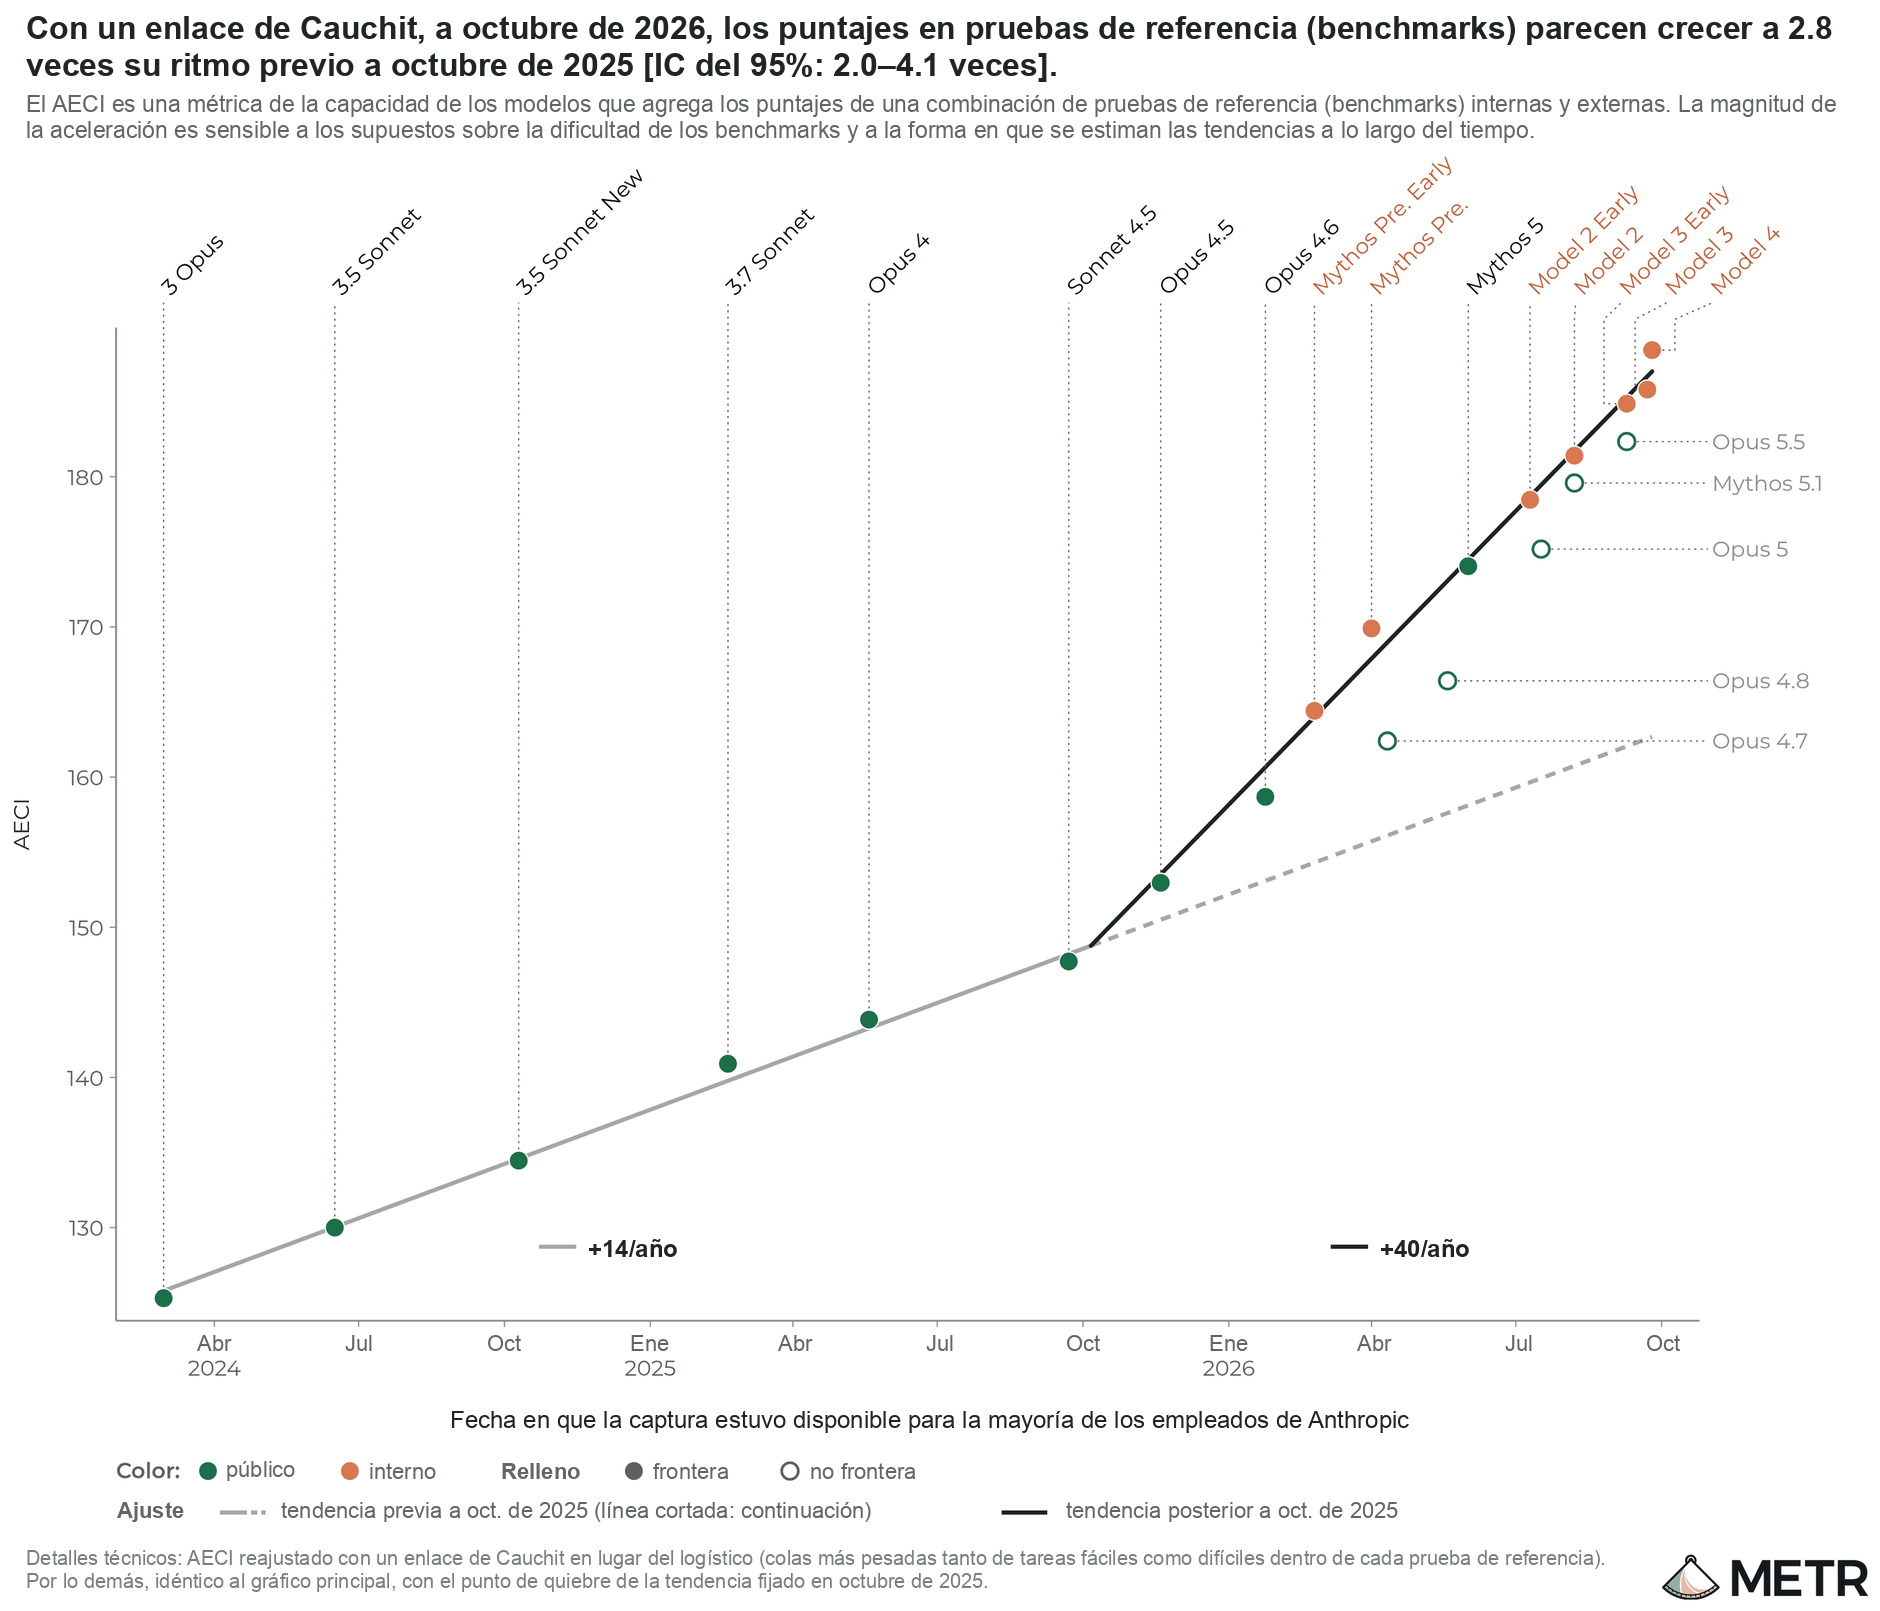 |
| Log-log complementaria (cola izquierda pesada) | Las pruebas de referencia tienen una cola mayor únicamente de problemas fáciles (por ejemplo, si hay muchas tareas fáciles de adivinar). | 1.1 veces [0.8–1.5] | 87.1% | 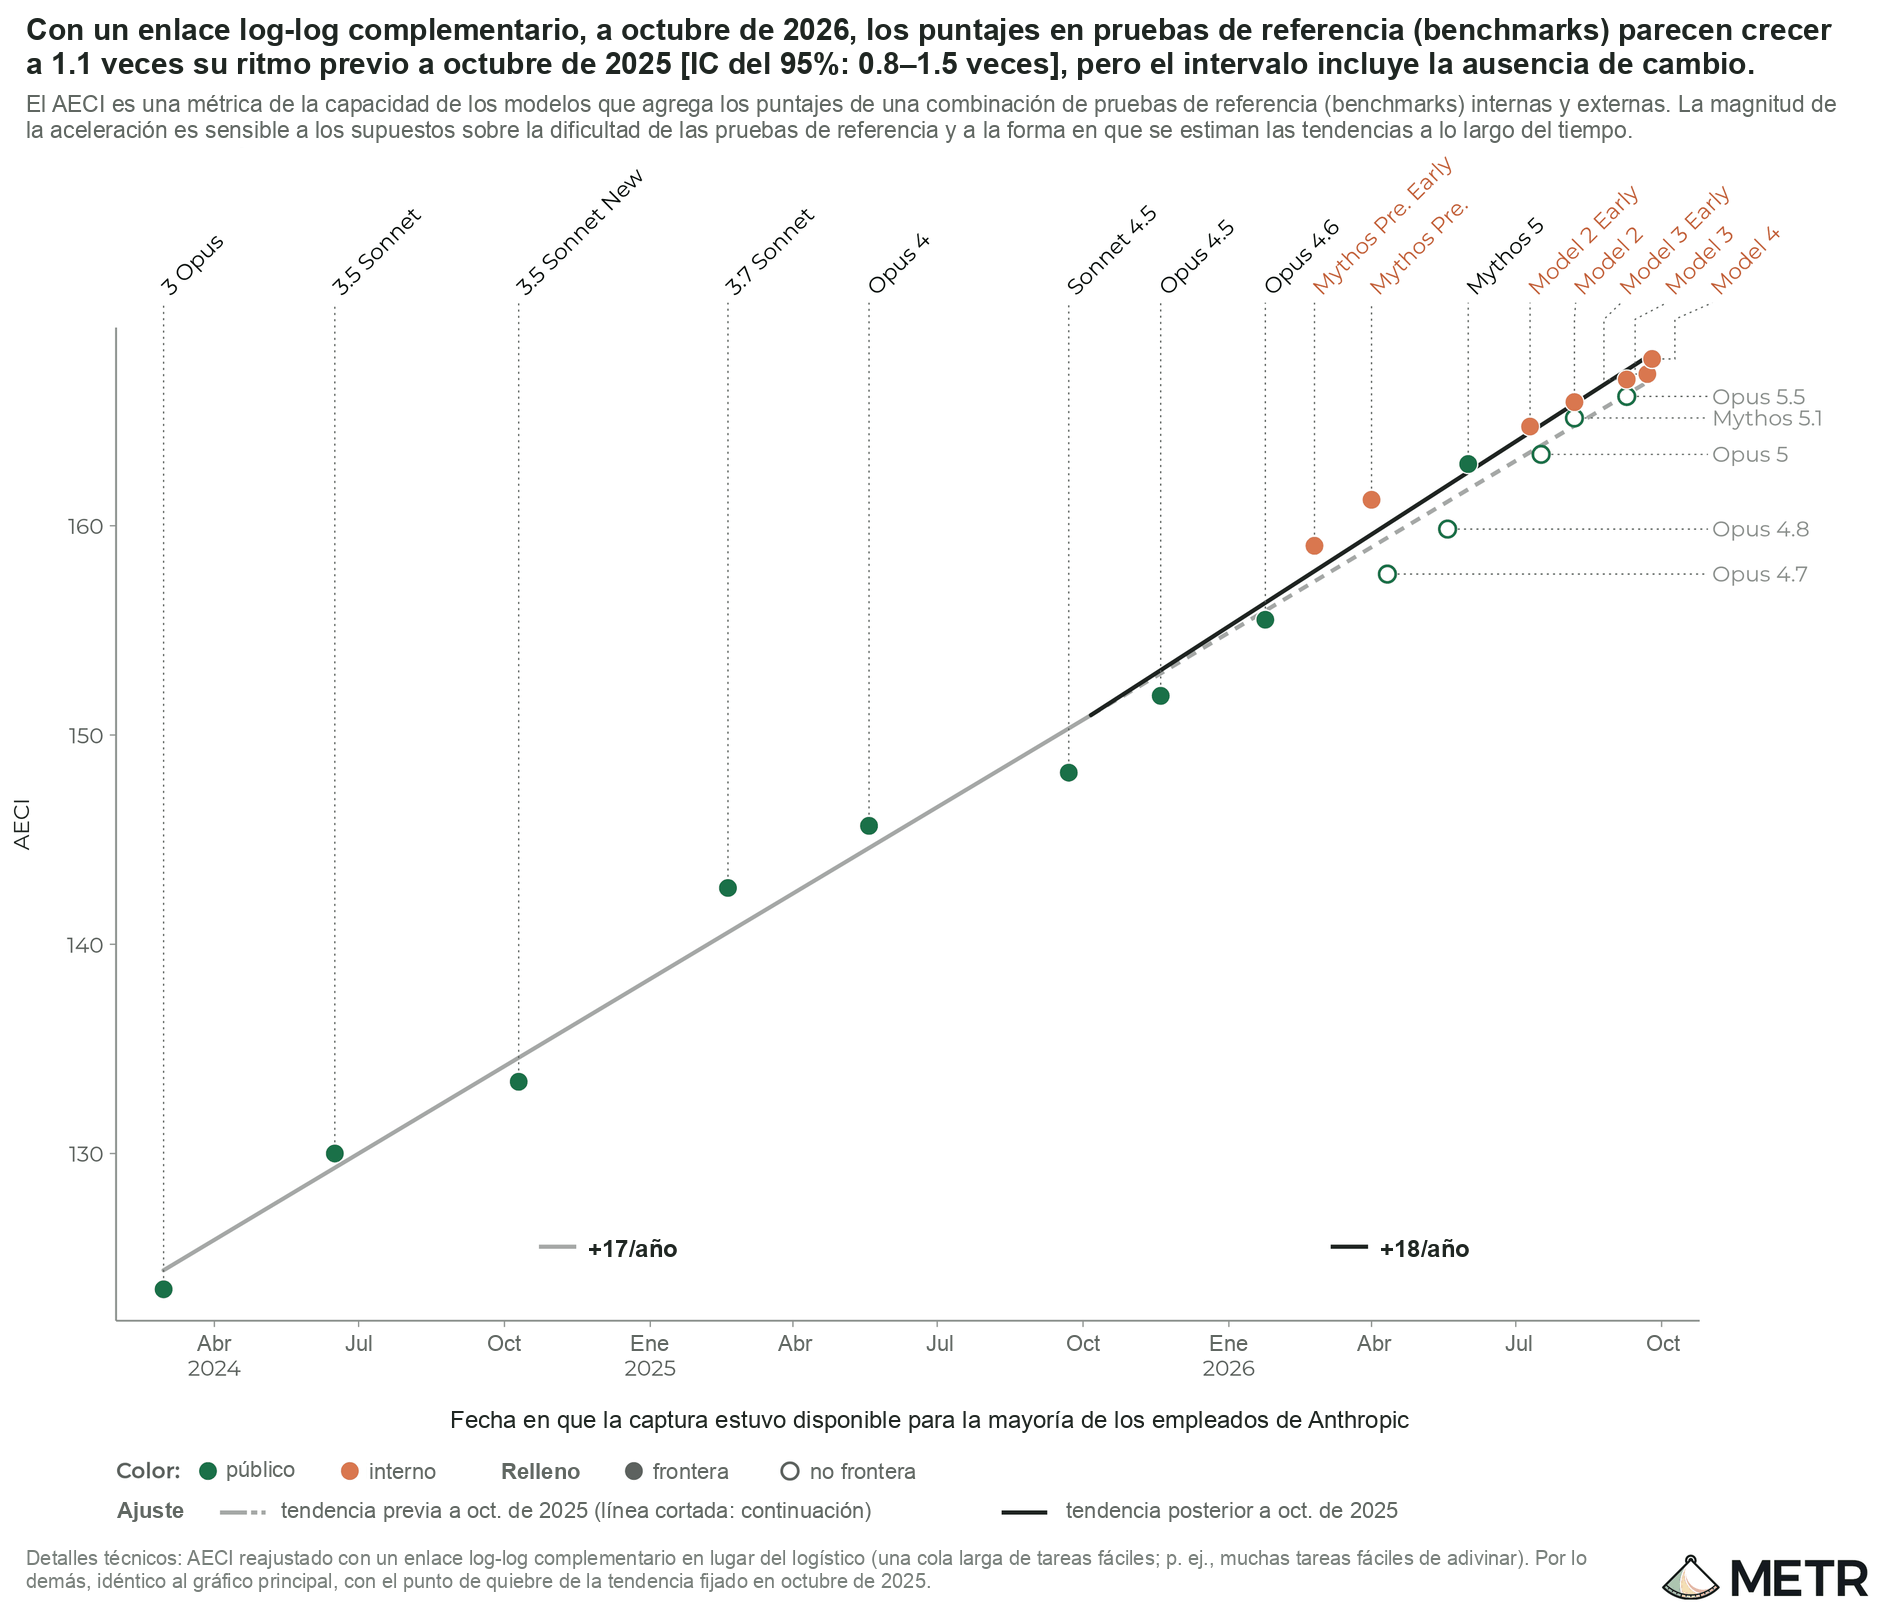 |
| Log-log (cola derecha pesada) | Las pruebas de referencia tienen una cola mayor únicamente de problemas difíciles (por ejemplo, si hay unos pocos problemas extremadamente difíciles). | 2.9 veces [2.1–4.9] | 86.9% | 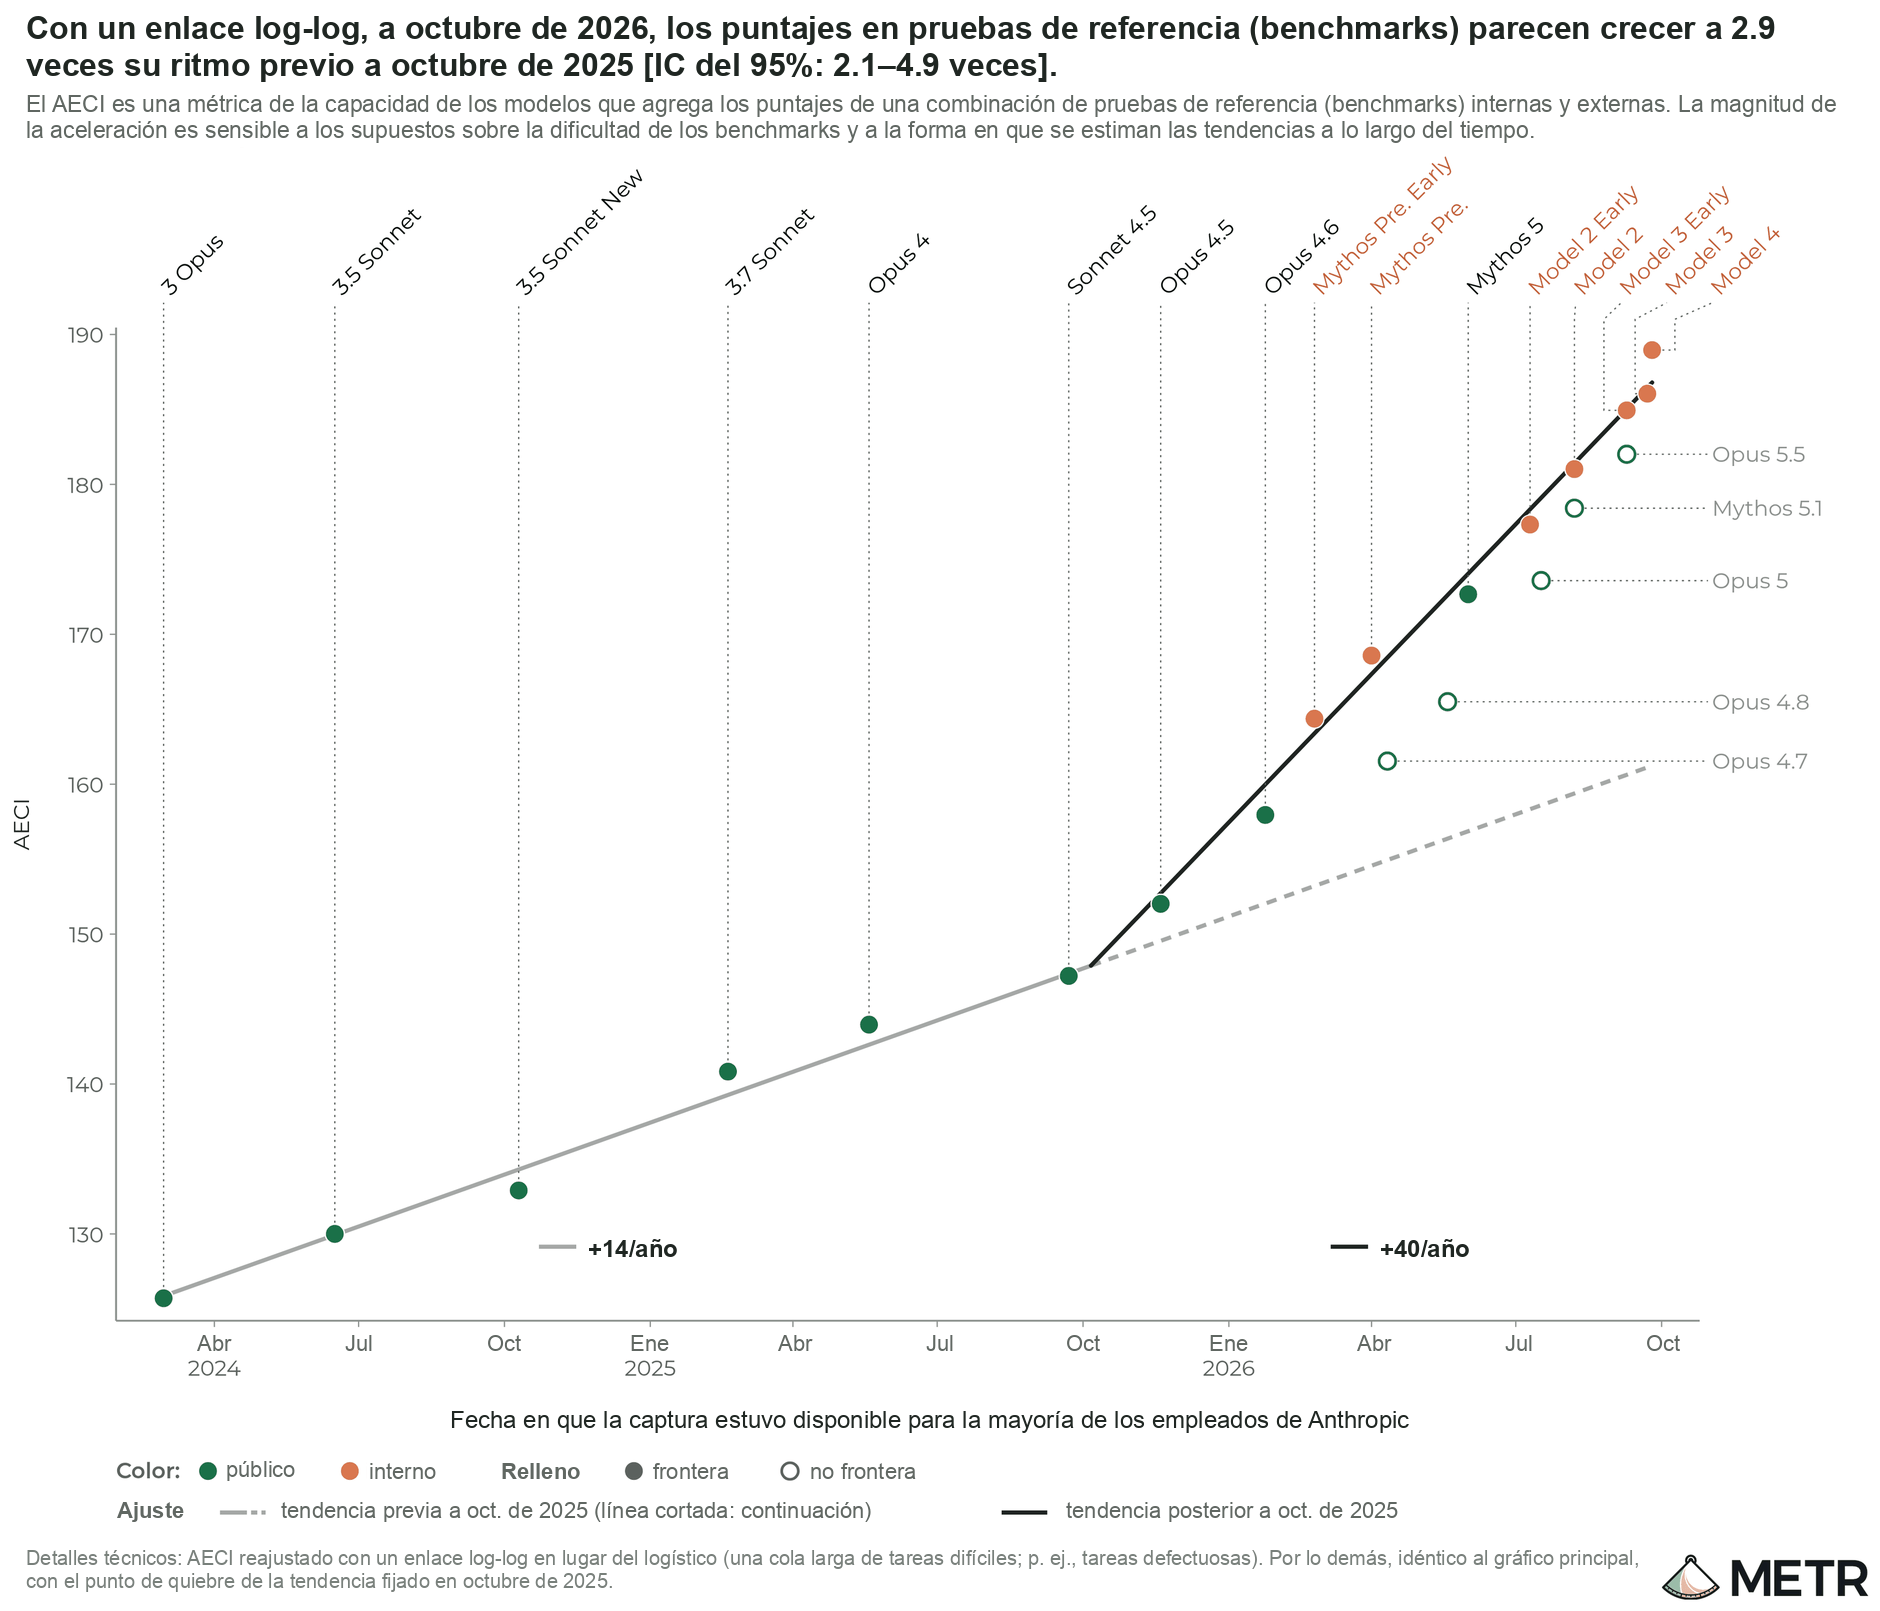 |
| Función de enlace aprendida (familia de dos colas de Stukel, con 2 parámetros aprendidos globalmente) | La longitud de ambas colas se estima globalmente a partir de los datos. | 2.6 veces [1.8–4.1] | 87.0% | 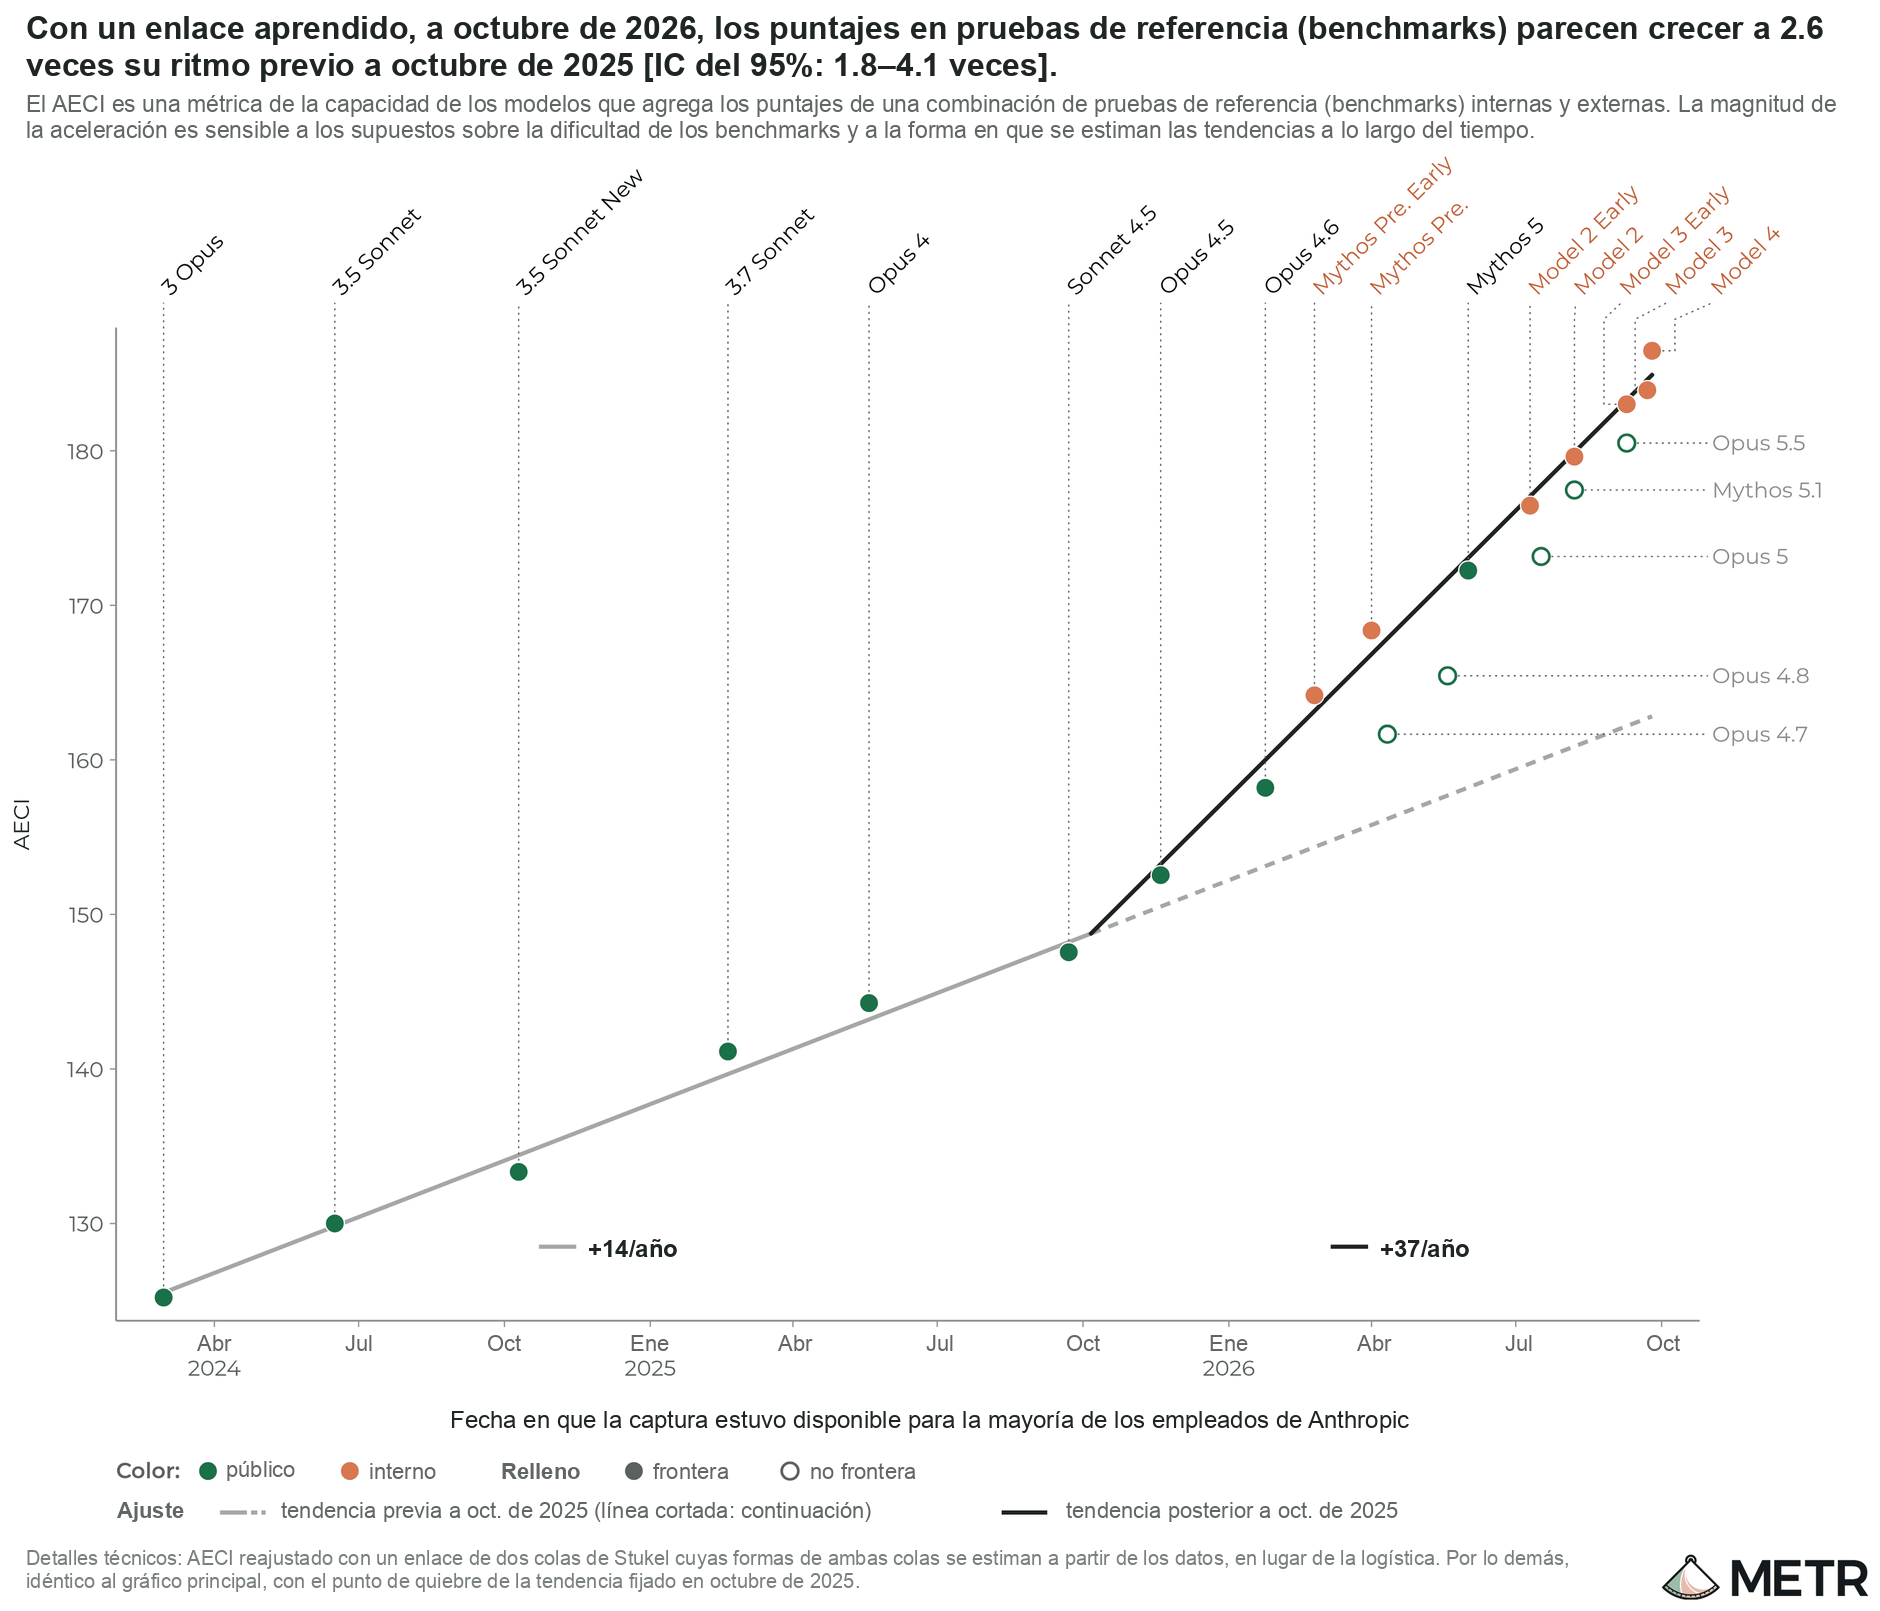 |
La calidad del ajuste es bastante similar en todas estas funciones de enlace (salvo la Cauchit), y no tenemos razones a priori sólidas para preferir una. Seguimos usando la logística para nuestros resultados principales porque es la función de enlace predeterminada que usan Epoch y Anthropic.
Robustez: una aceleración en el AECI de aproximadamente 2 veces parece ser robusta frente a las capturas que se incluyan.
Consideramos diversas alternativas sobre qué modelos usar al estimar el crecimiento del AECI:
| Parametrización | Aceleración | Figura |
|---|---|---|
| AECI estándar (capturas que tuvieron un uso interno sustancial) | 1.9 veces [1.5–2.8] | arriba |
| Solo la captura más alta por modelo | 1.9 veces [1.4–2.8] | |
| Solo la primera captura por modelo | 2.2 veces [1.3–3.2] | |
| Un subconjunto de modelos (por razones suprimidas) | 1.9 veces [1.4–3.3] | [este gráfico fue suprimido por Anthropic] |
| Todas las capturas | 1.9 veces [1.4–2.6] |
Robustez: una aceleración en el AECI de aproximadamente 2 veces parece ser robusta frente a las pruebas de referencia (benchmarks) que se incluyan.
Consideramos diversas alternativas sobre qué pruebas de referencia (benchmarks) usar al estimar el crecimiento del AECI:
| Parametrización | Aceleración | Figura |
|---|---|---|
| AECI estándar | 1.9 veces [1.5–2.8] | arriba |
| Excluyendo pruebas de referencia (benchmarks) de visión (como OSWorld, MMMU). | 2.2 veces [1.7–3.5] | 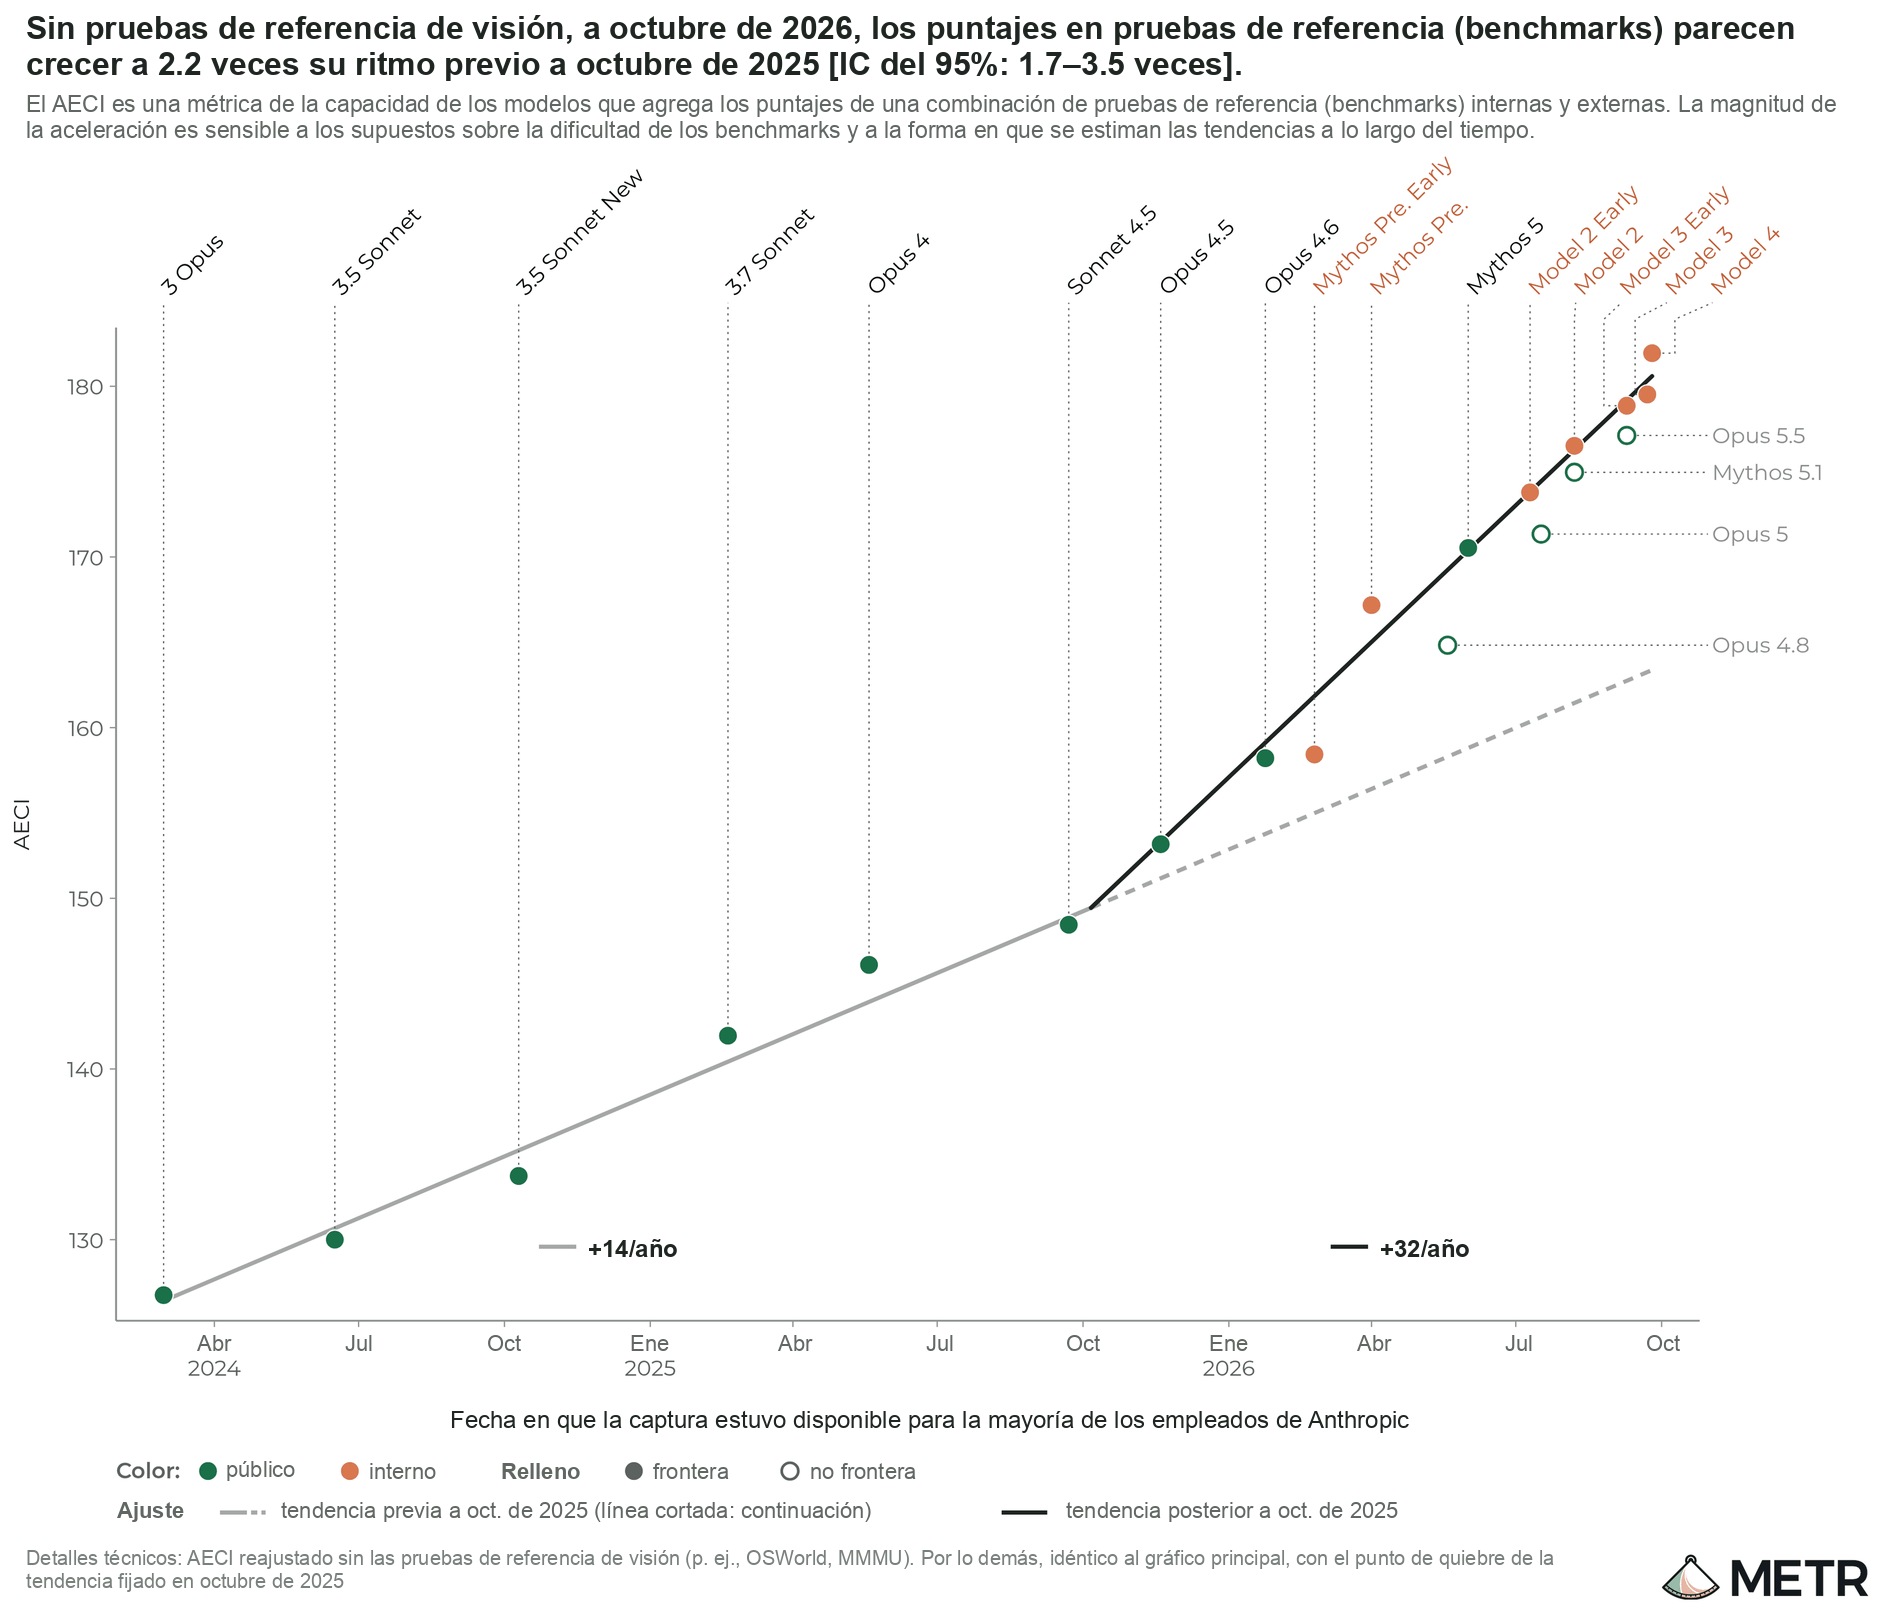 |
| Conservando únicamente las pruebas de referencia (benchmarks) que Claude categoriza como relevantes para la I+D en IA (p. ej., se descarta MMLU multilingüe y los benchmarks de honestidad). | 2.0 veces [1.5–2.9] | 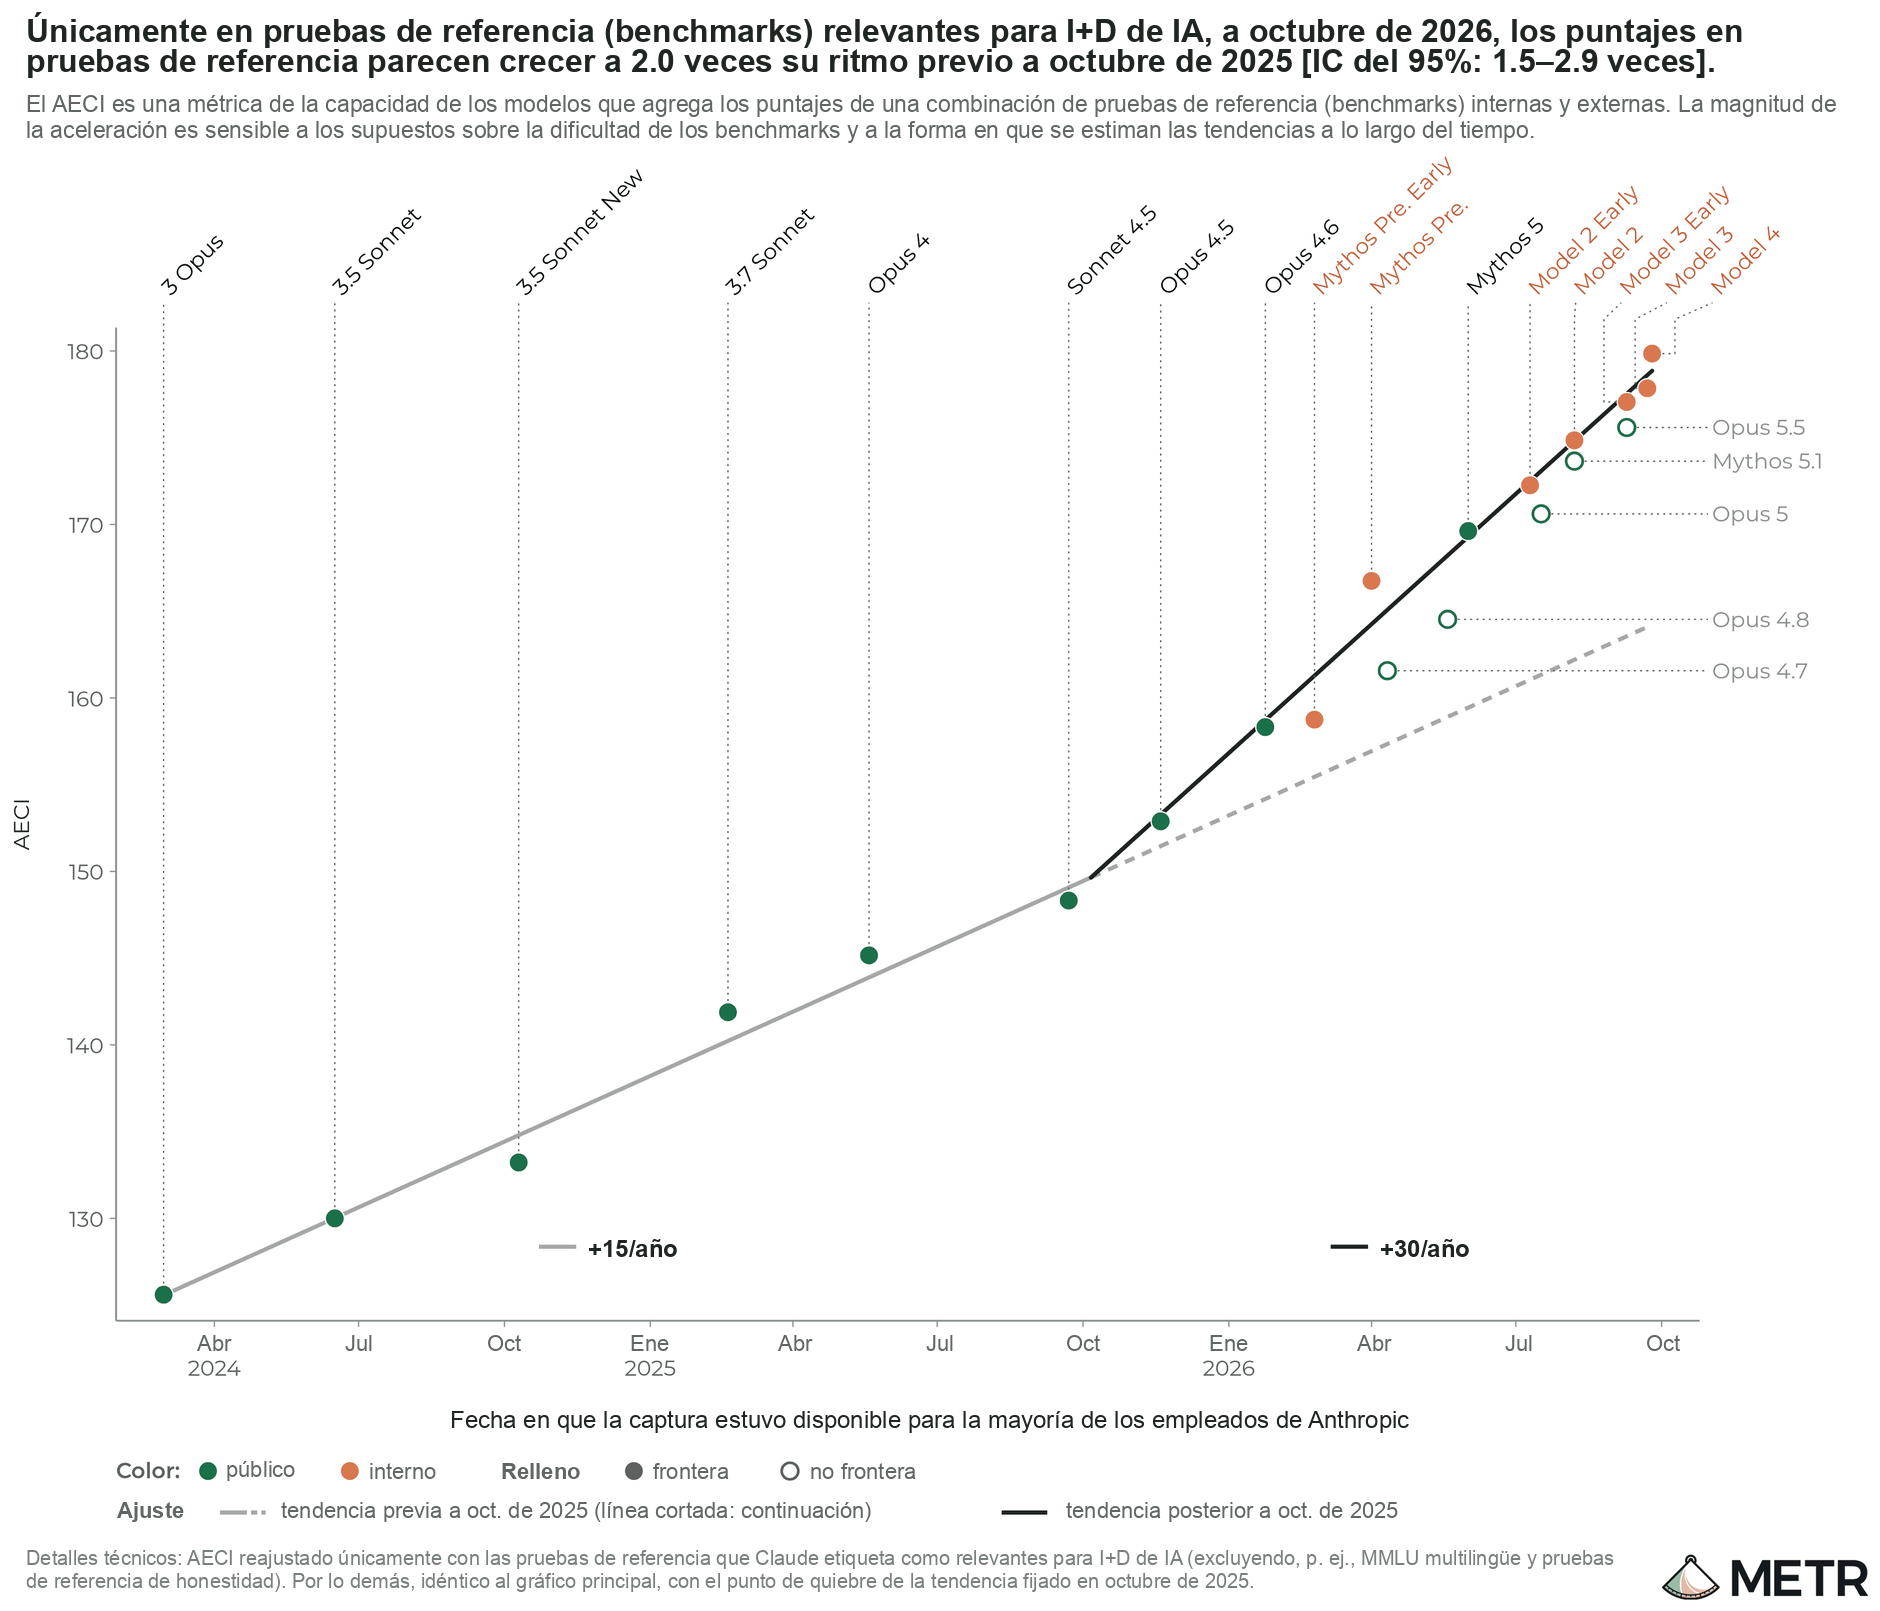 |
| Descartando las pruebas de referencia (benchmarks) cuyo puntaje, en promedio, disminuye a medida que aumenta el AECI. (Esto puede indicar un benchmark defectuoso, ya que modelos con mayor capacidad general obtienen puntajes más bajos). | 1.9 veces [1.6–2.8] | 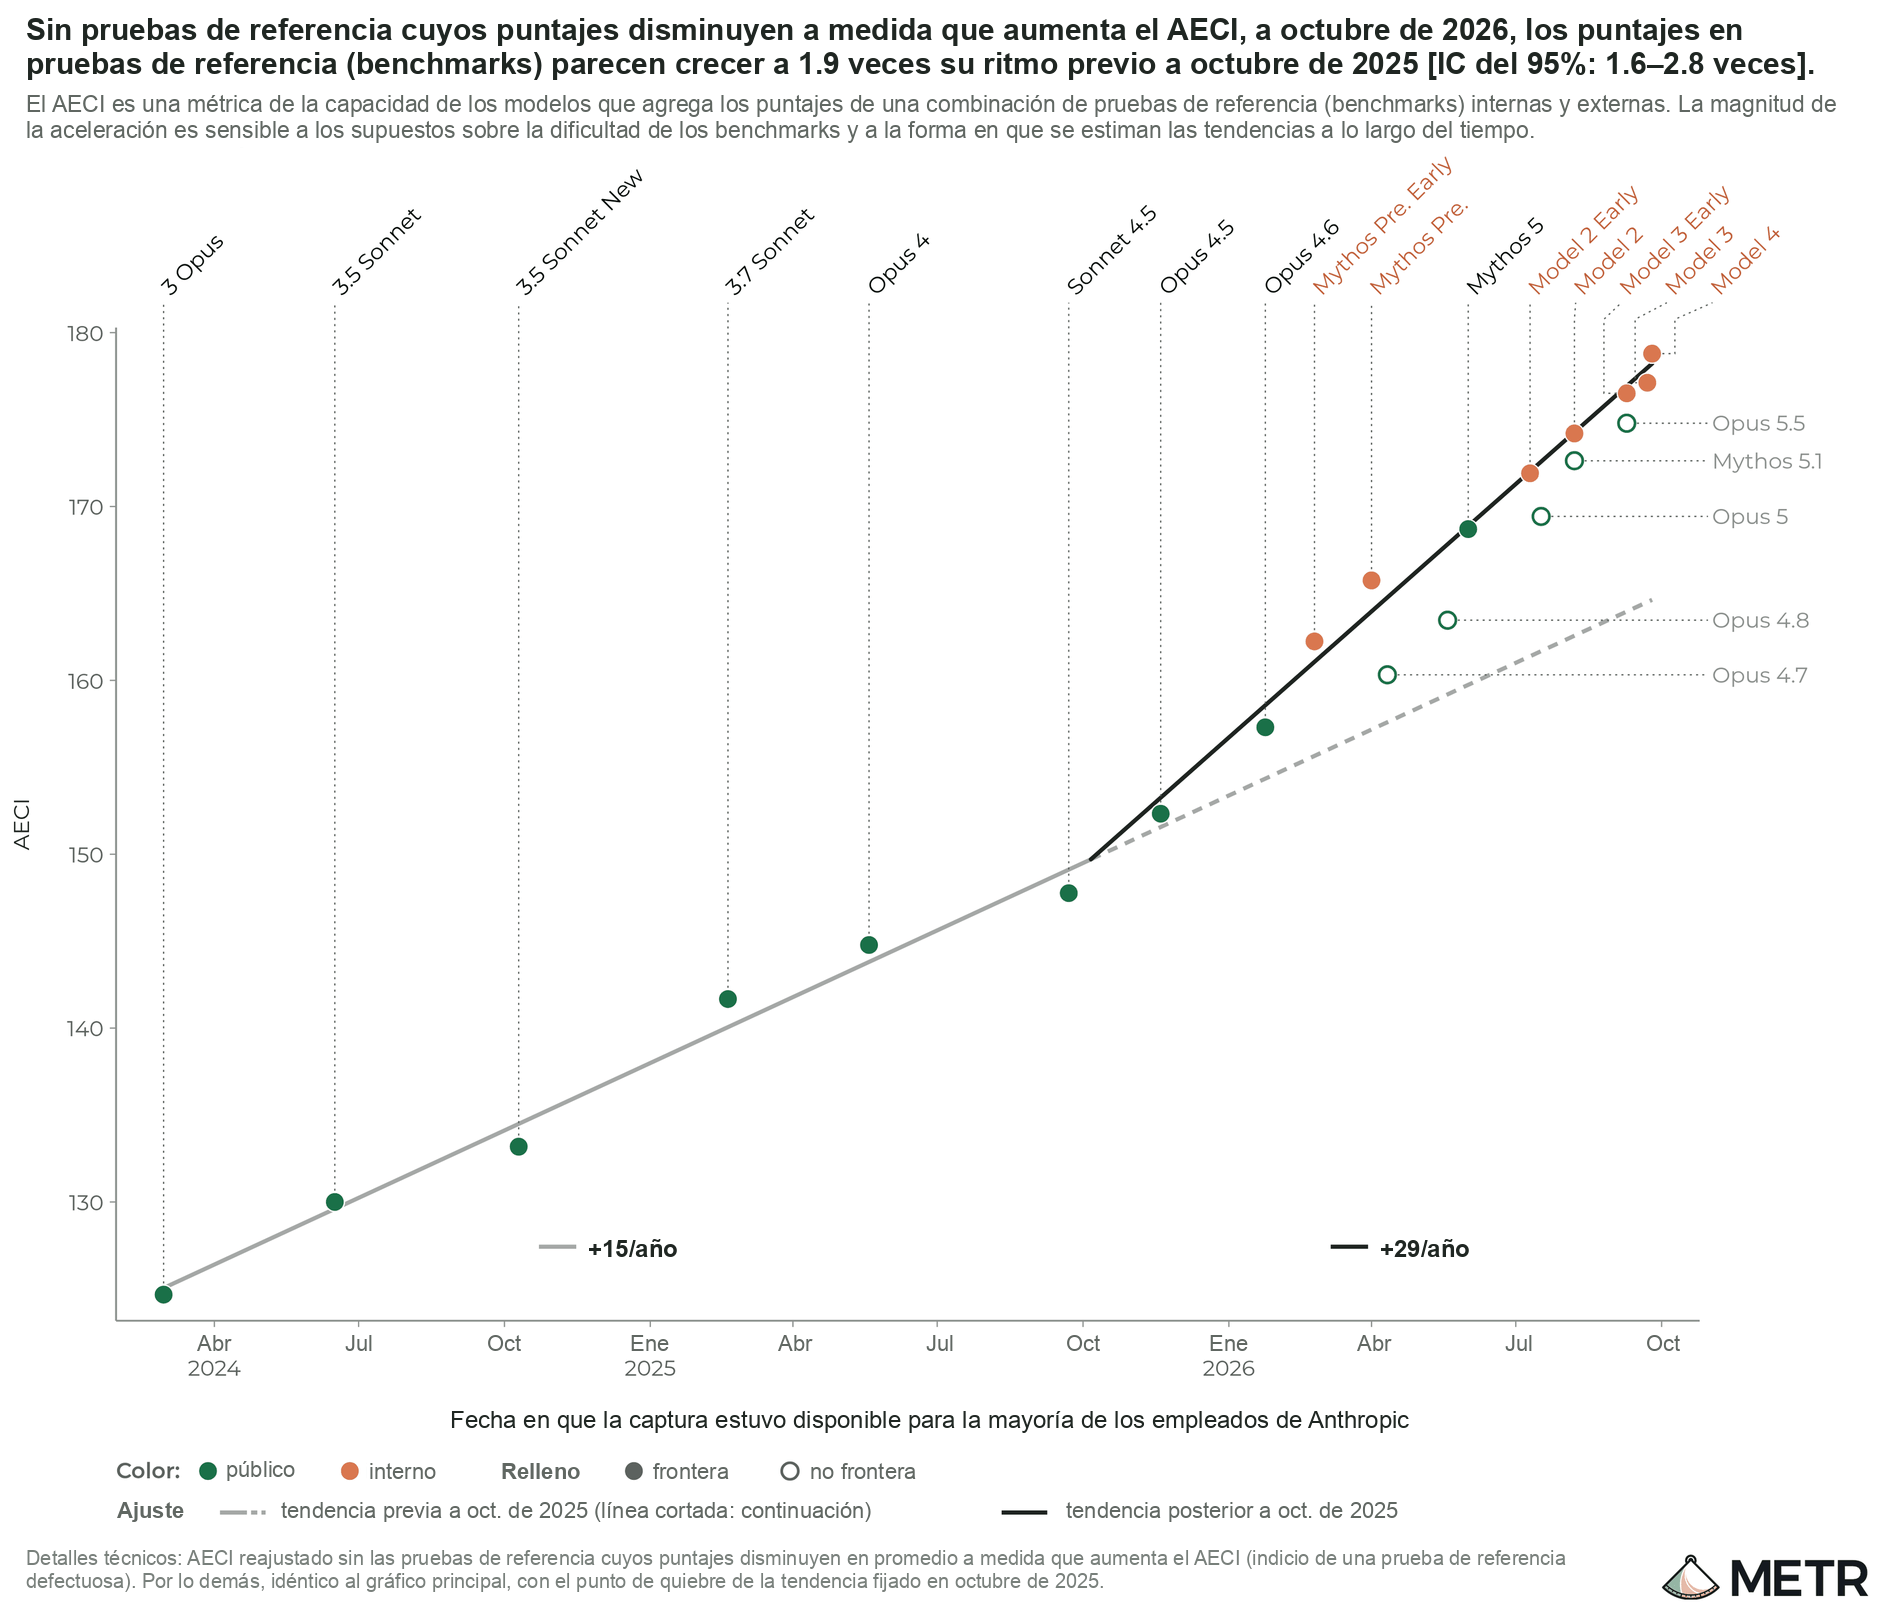 |
| Descartando las pruebas de referencia (benchmarks) en las que el ajuste logístico tiene una R² inferior al 50%. (Esto elimina los benchmarks para los cuales la función de enlace logística no se ajusta bien). | 1.9 veces [1.4–2.6] | 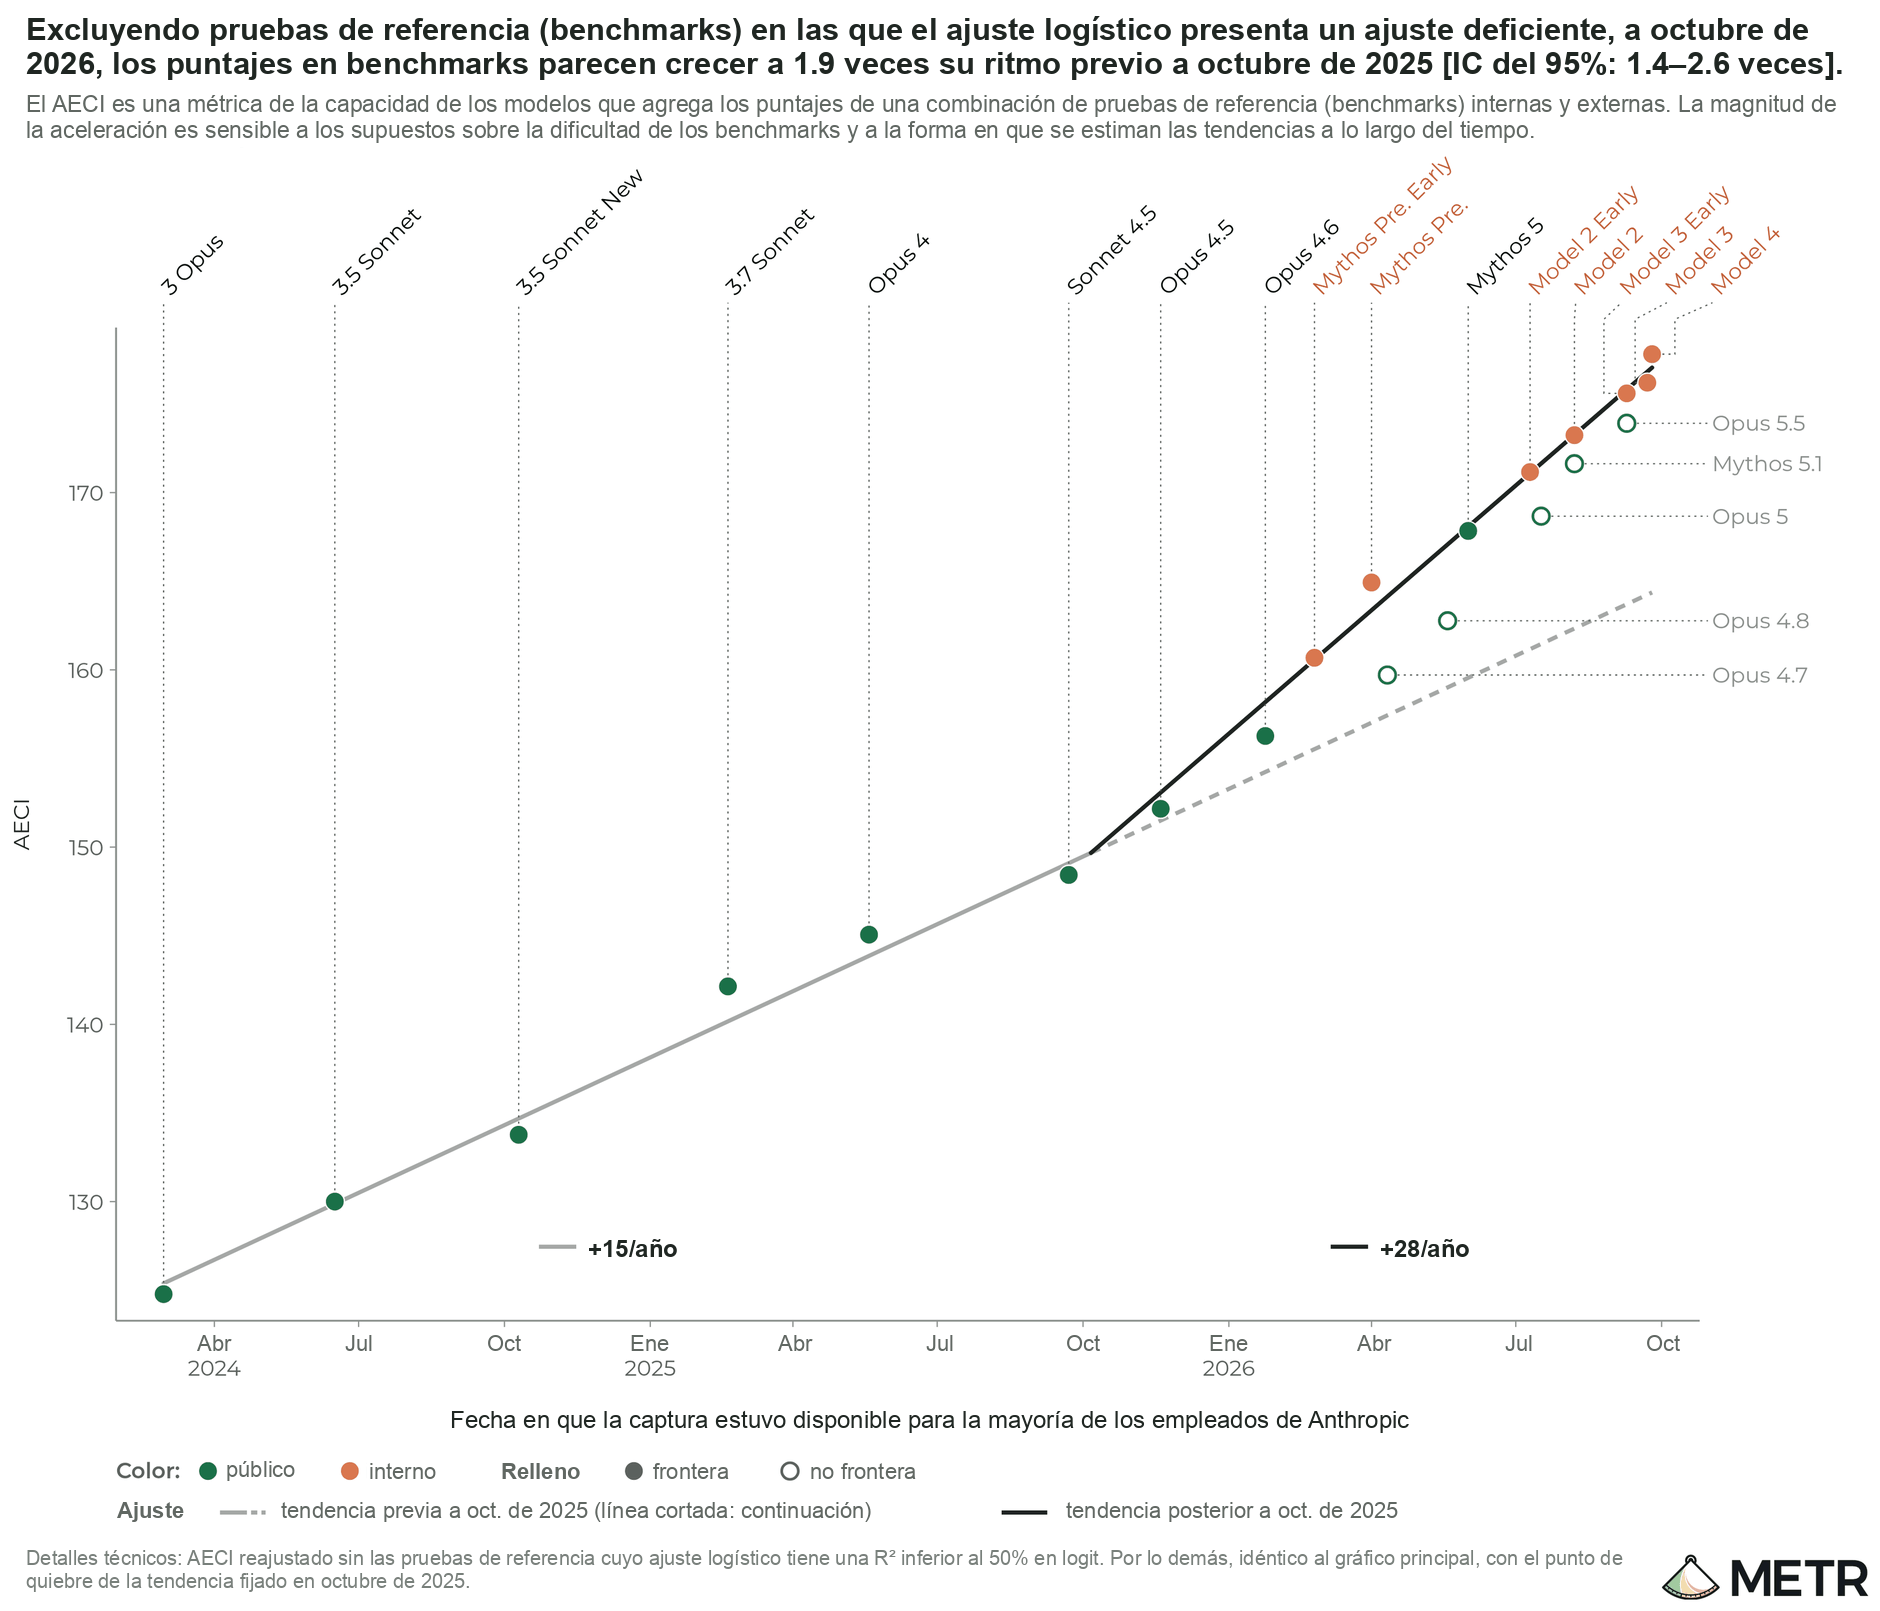 |
| Excluyendo las pruebas de referencia (benchmarks) una vez que alcanzan un puntaje del 85% (para mayor robustez frente a la saturación). | 1.9 veces [1.4–2.3] | 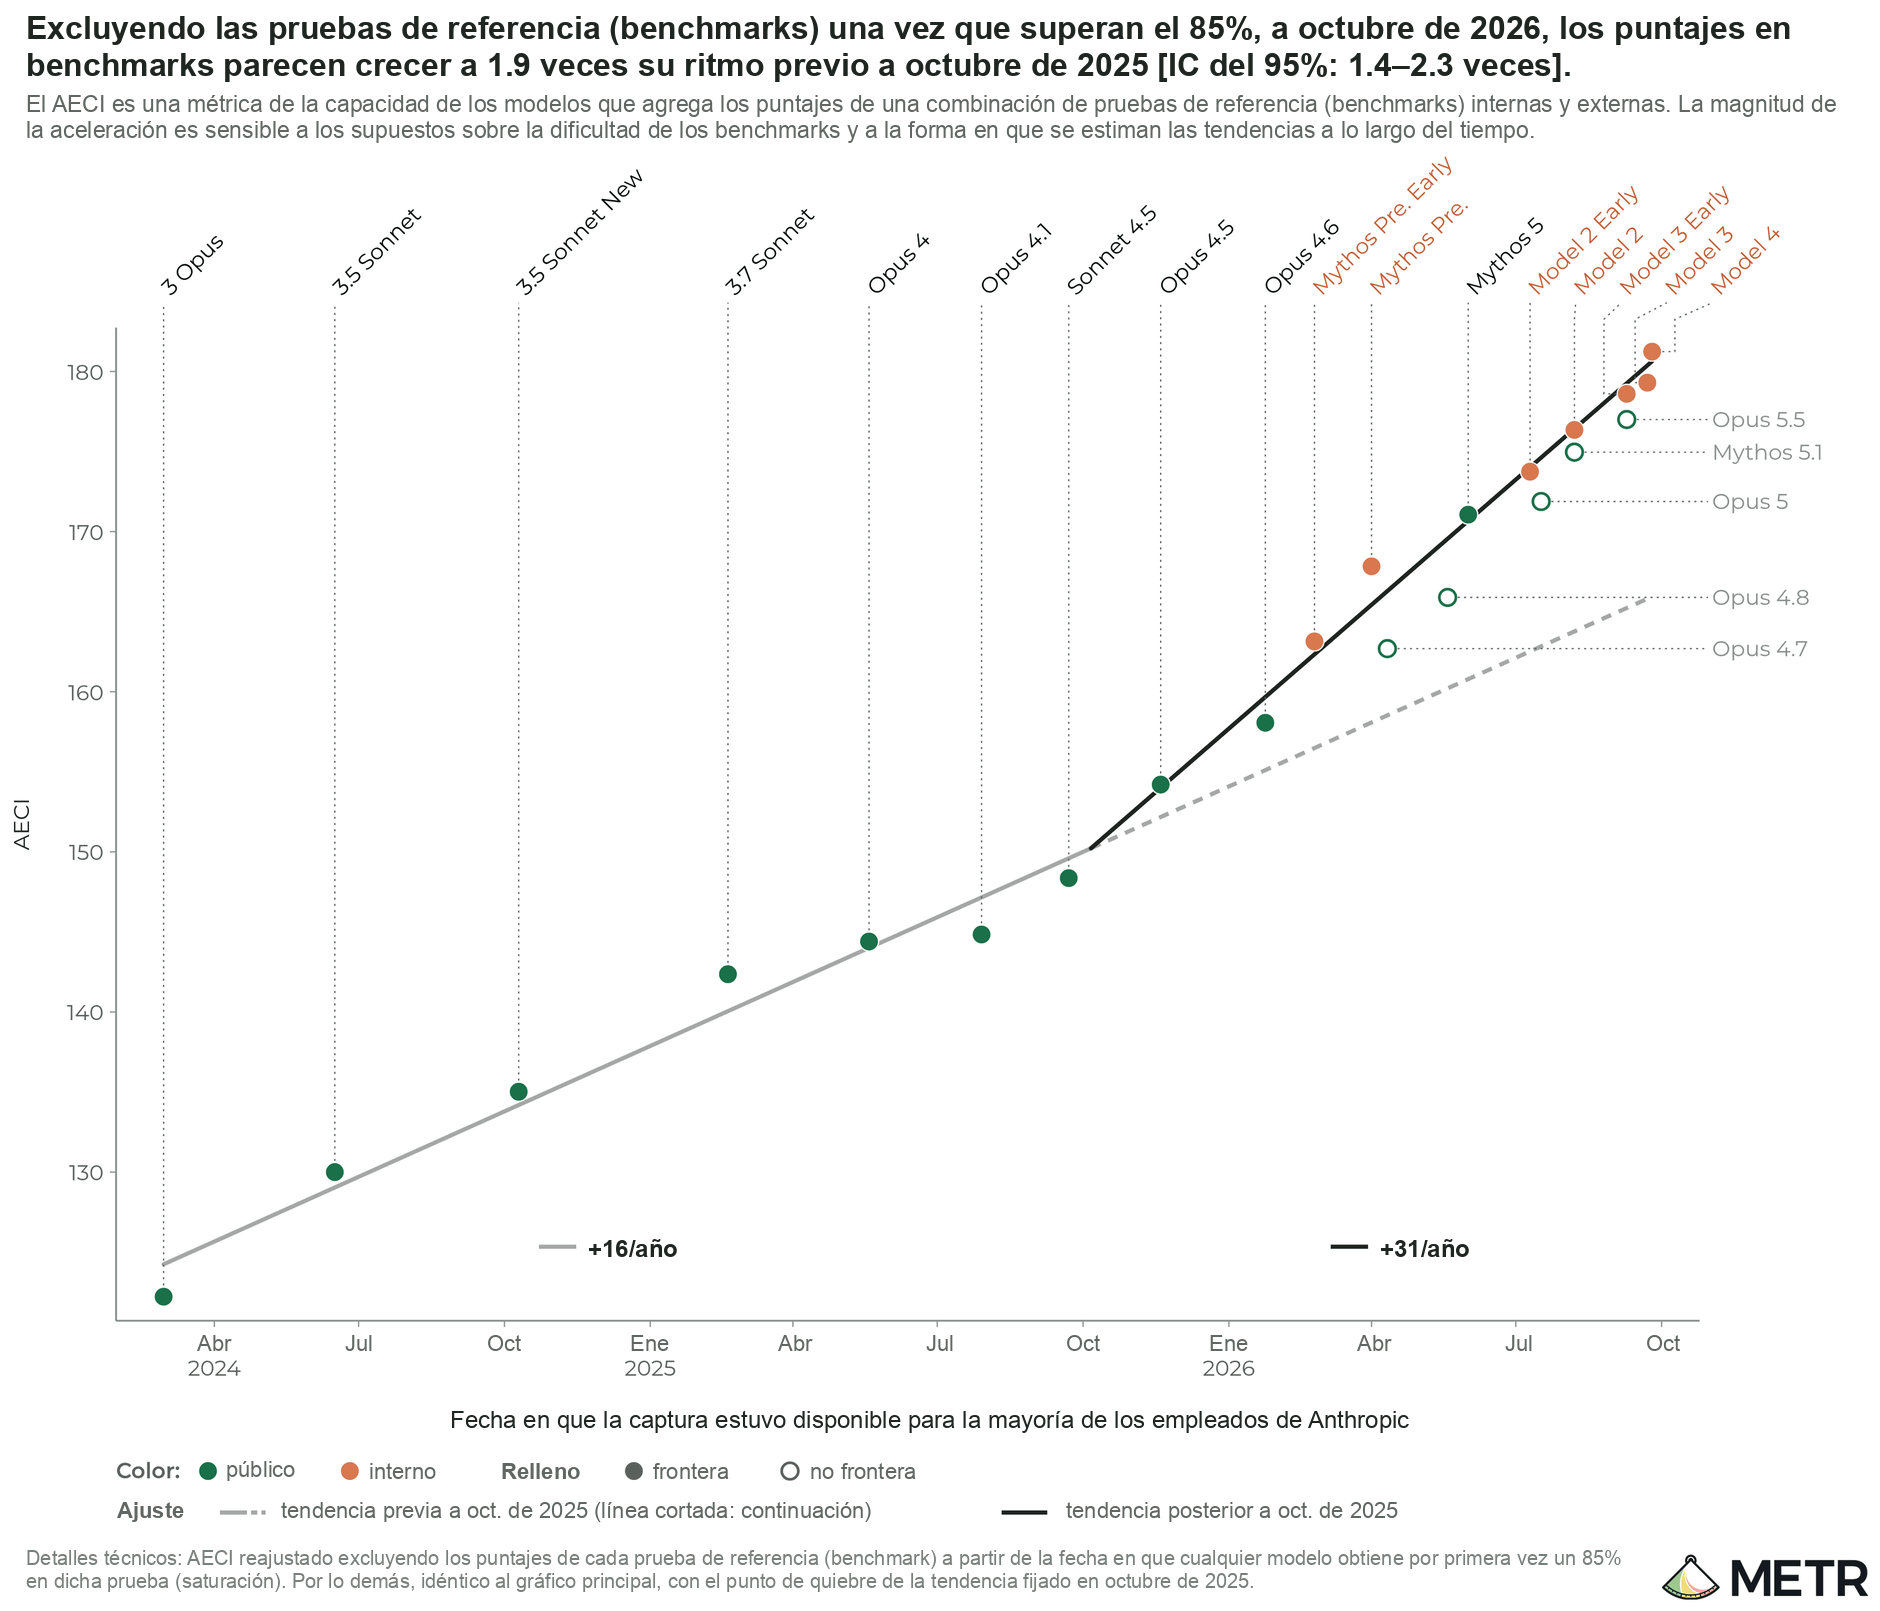 |
Robustez: una aceleración en el AECI de aproximadamente 2 veces parece ser robusta frente a la regularización.
| Parametrización | Aceleración | Figura |
|---|---|---|
| AECI estándar | 1.9 veces [1.5–2.8] | arriba |
| Reducción de la regularización L2 en un factor de 10 | 1.9 veces [1.4–2.8] | 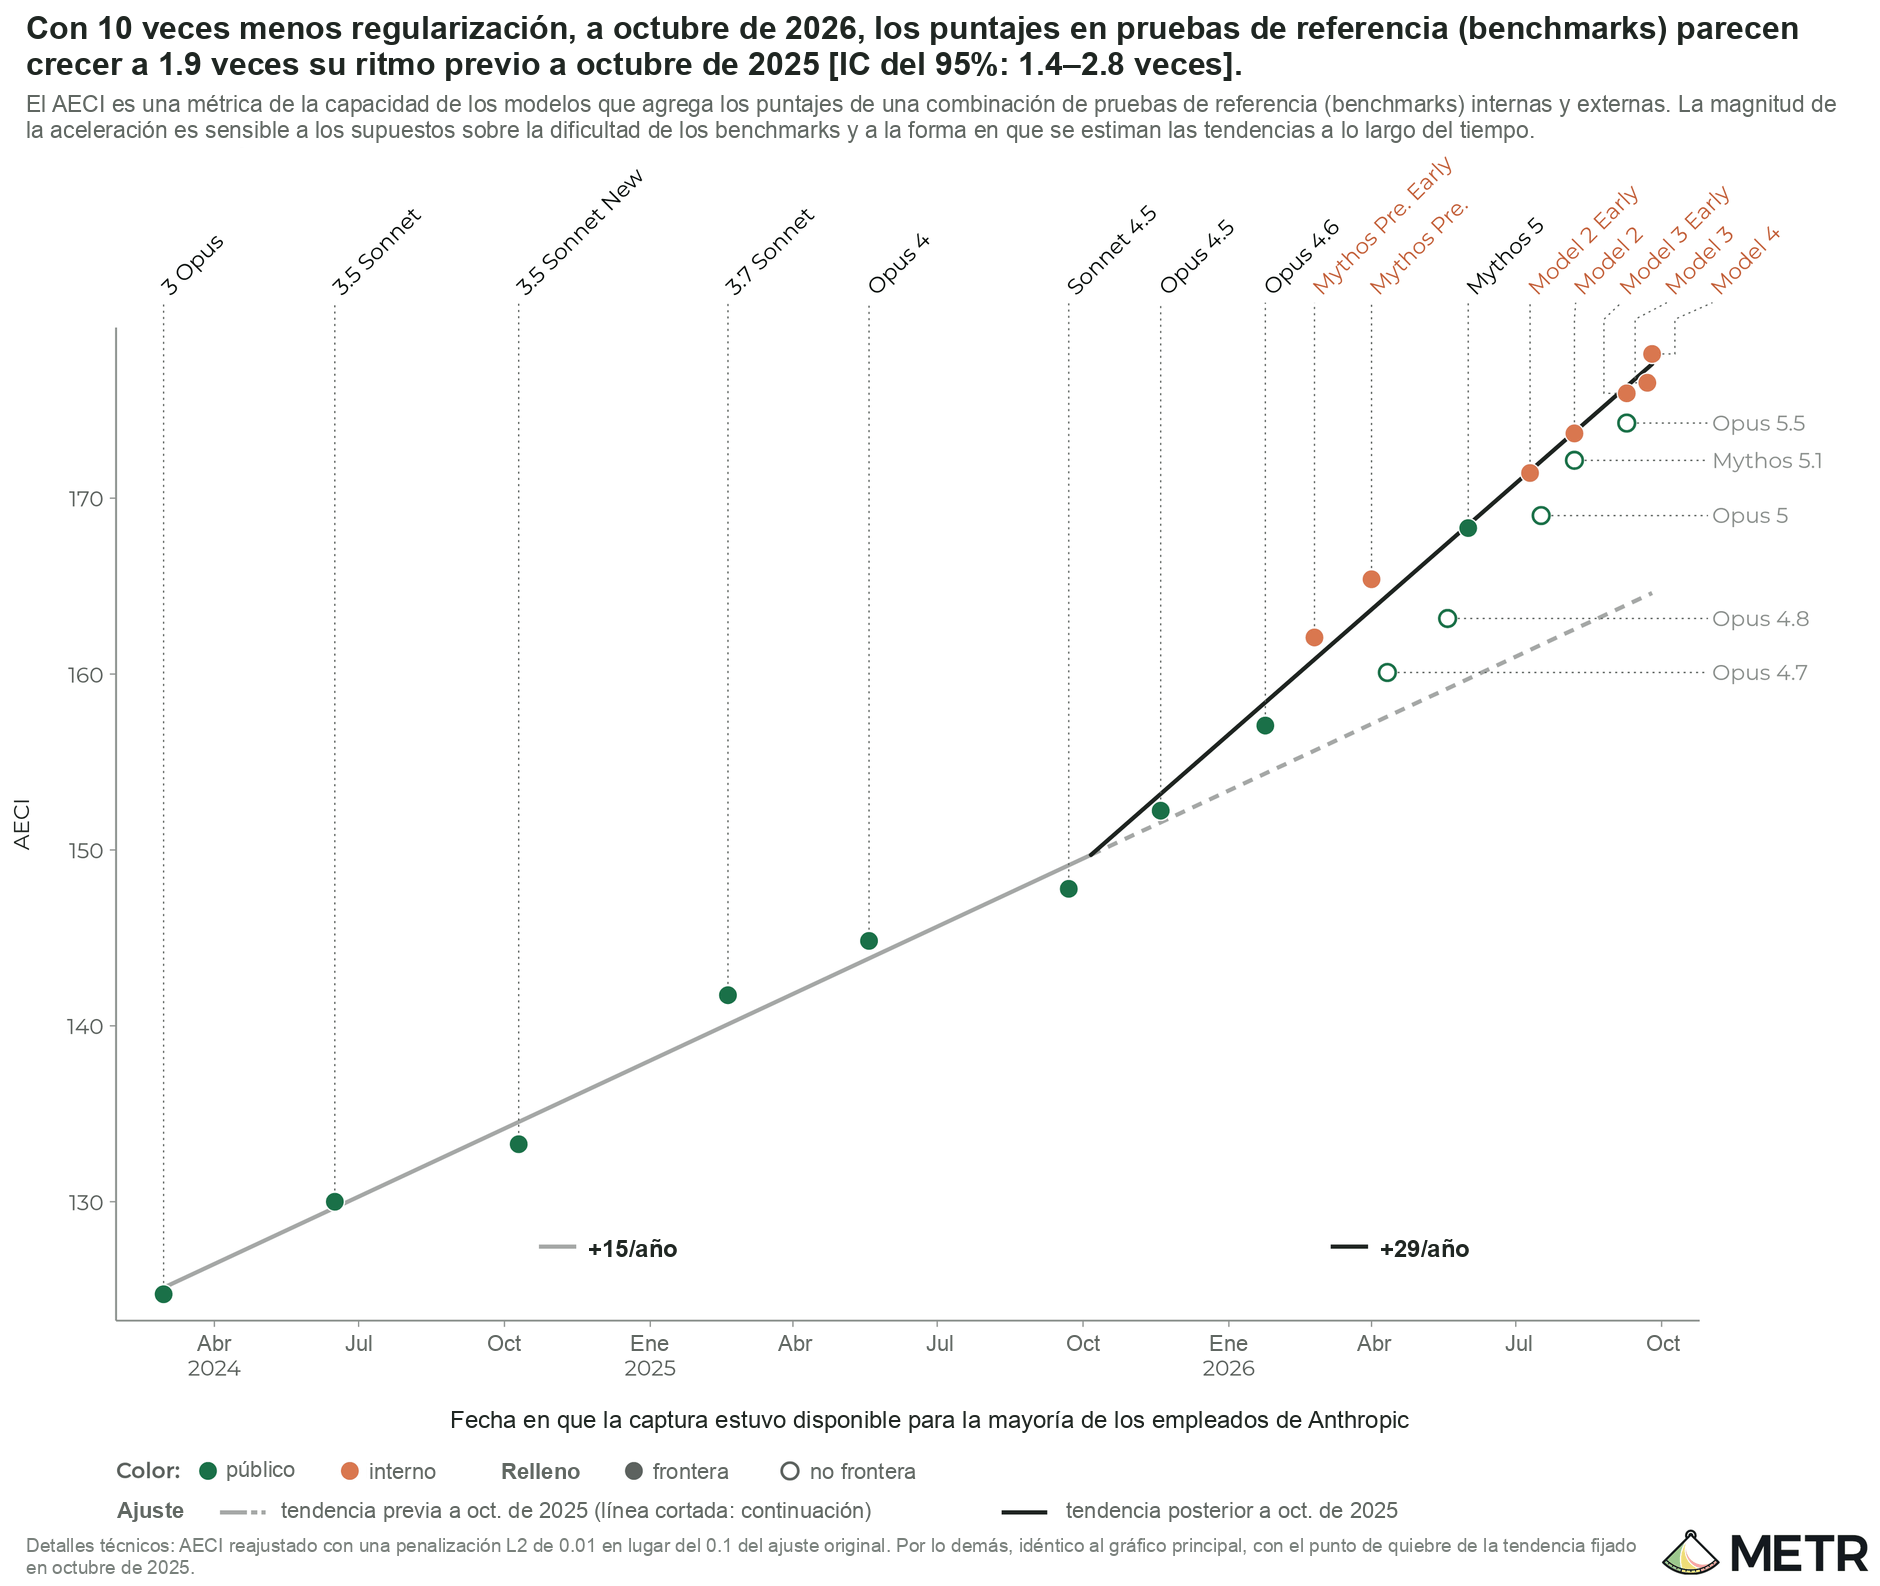 |
| Aumento de la regularización L2 por un factor de 10. | 2.1 veces [1.6–3.0] | 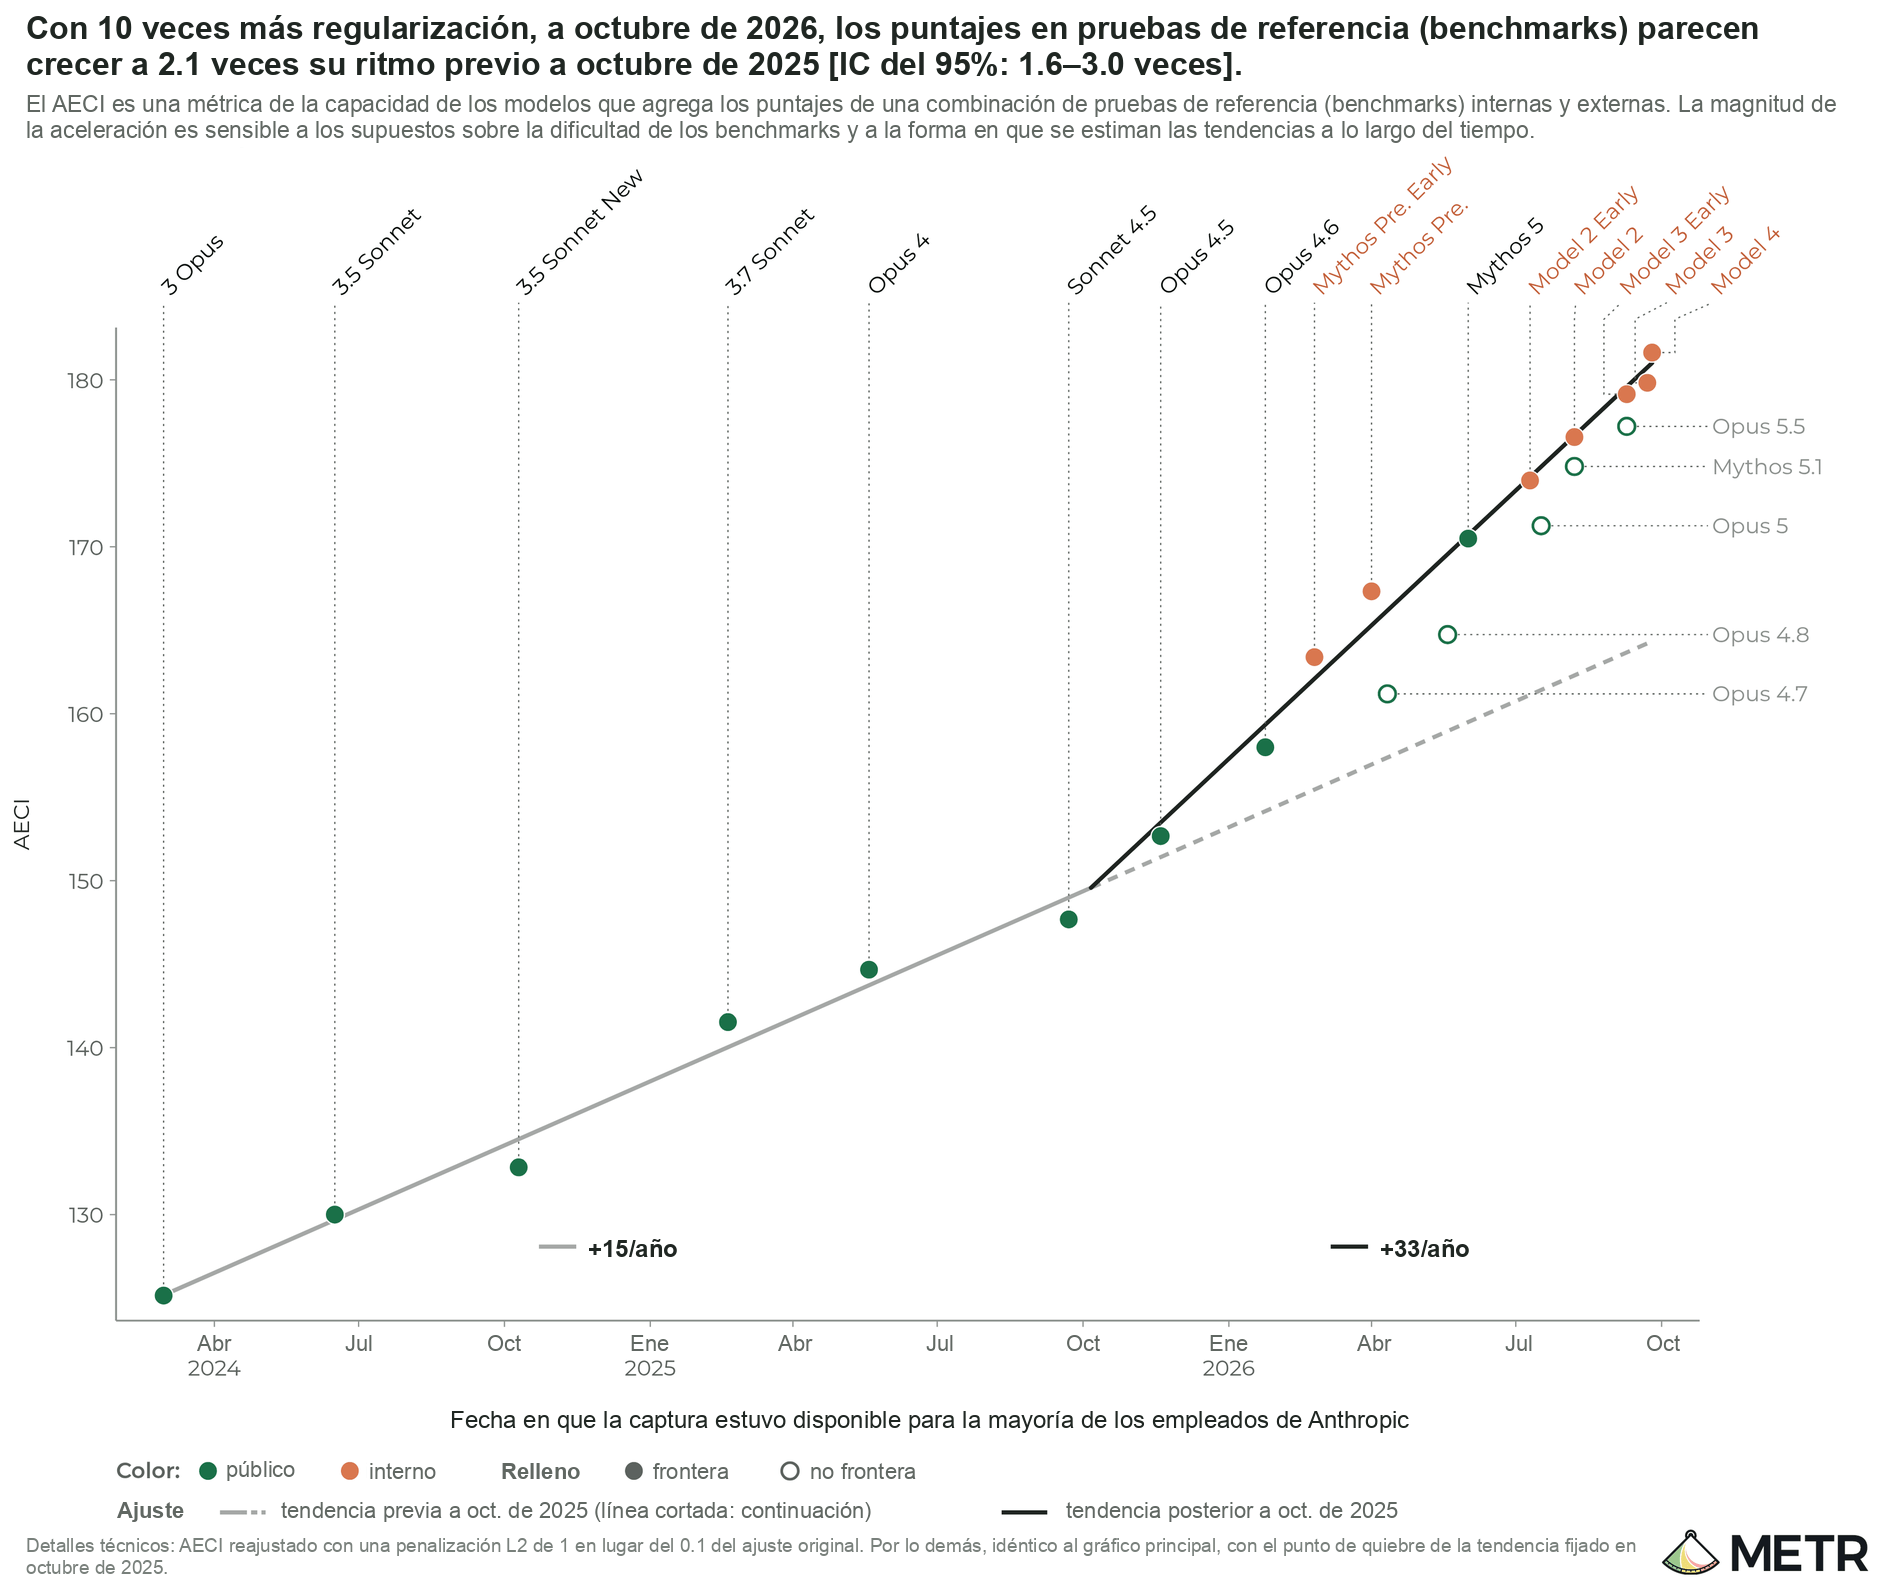 |
| Eliminación por completo de la regularización. | 1.9 veces [1.4–2.8] | 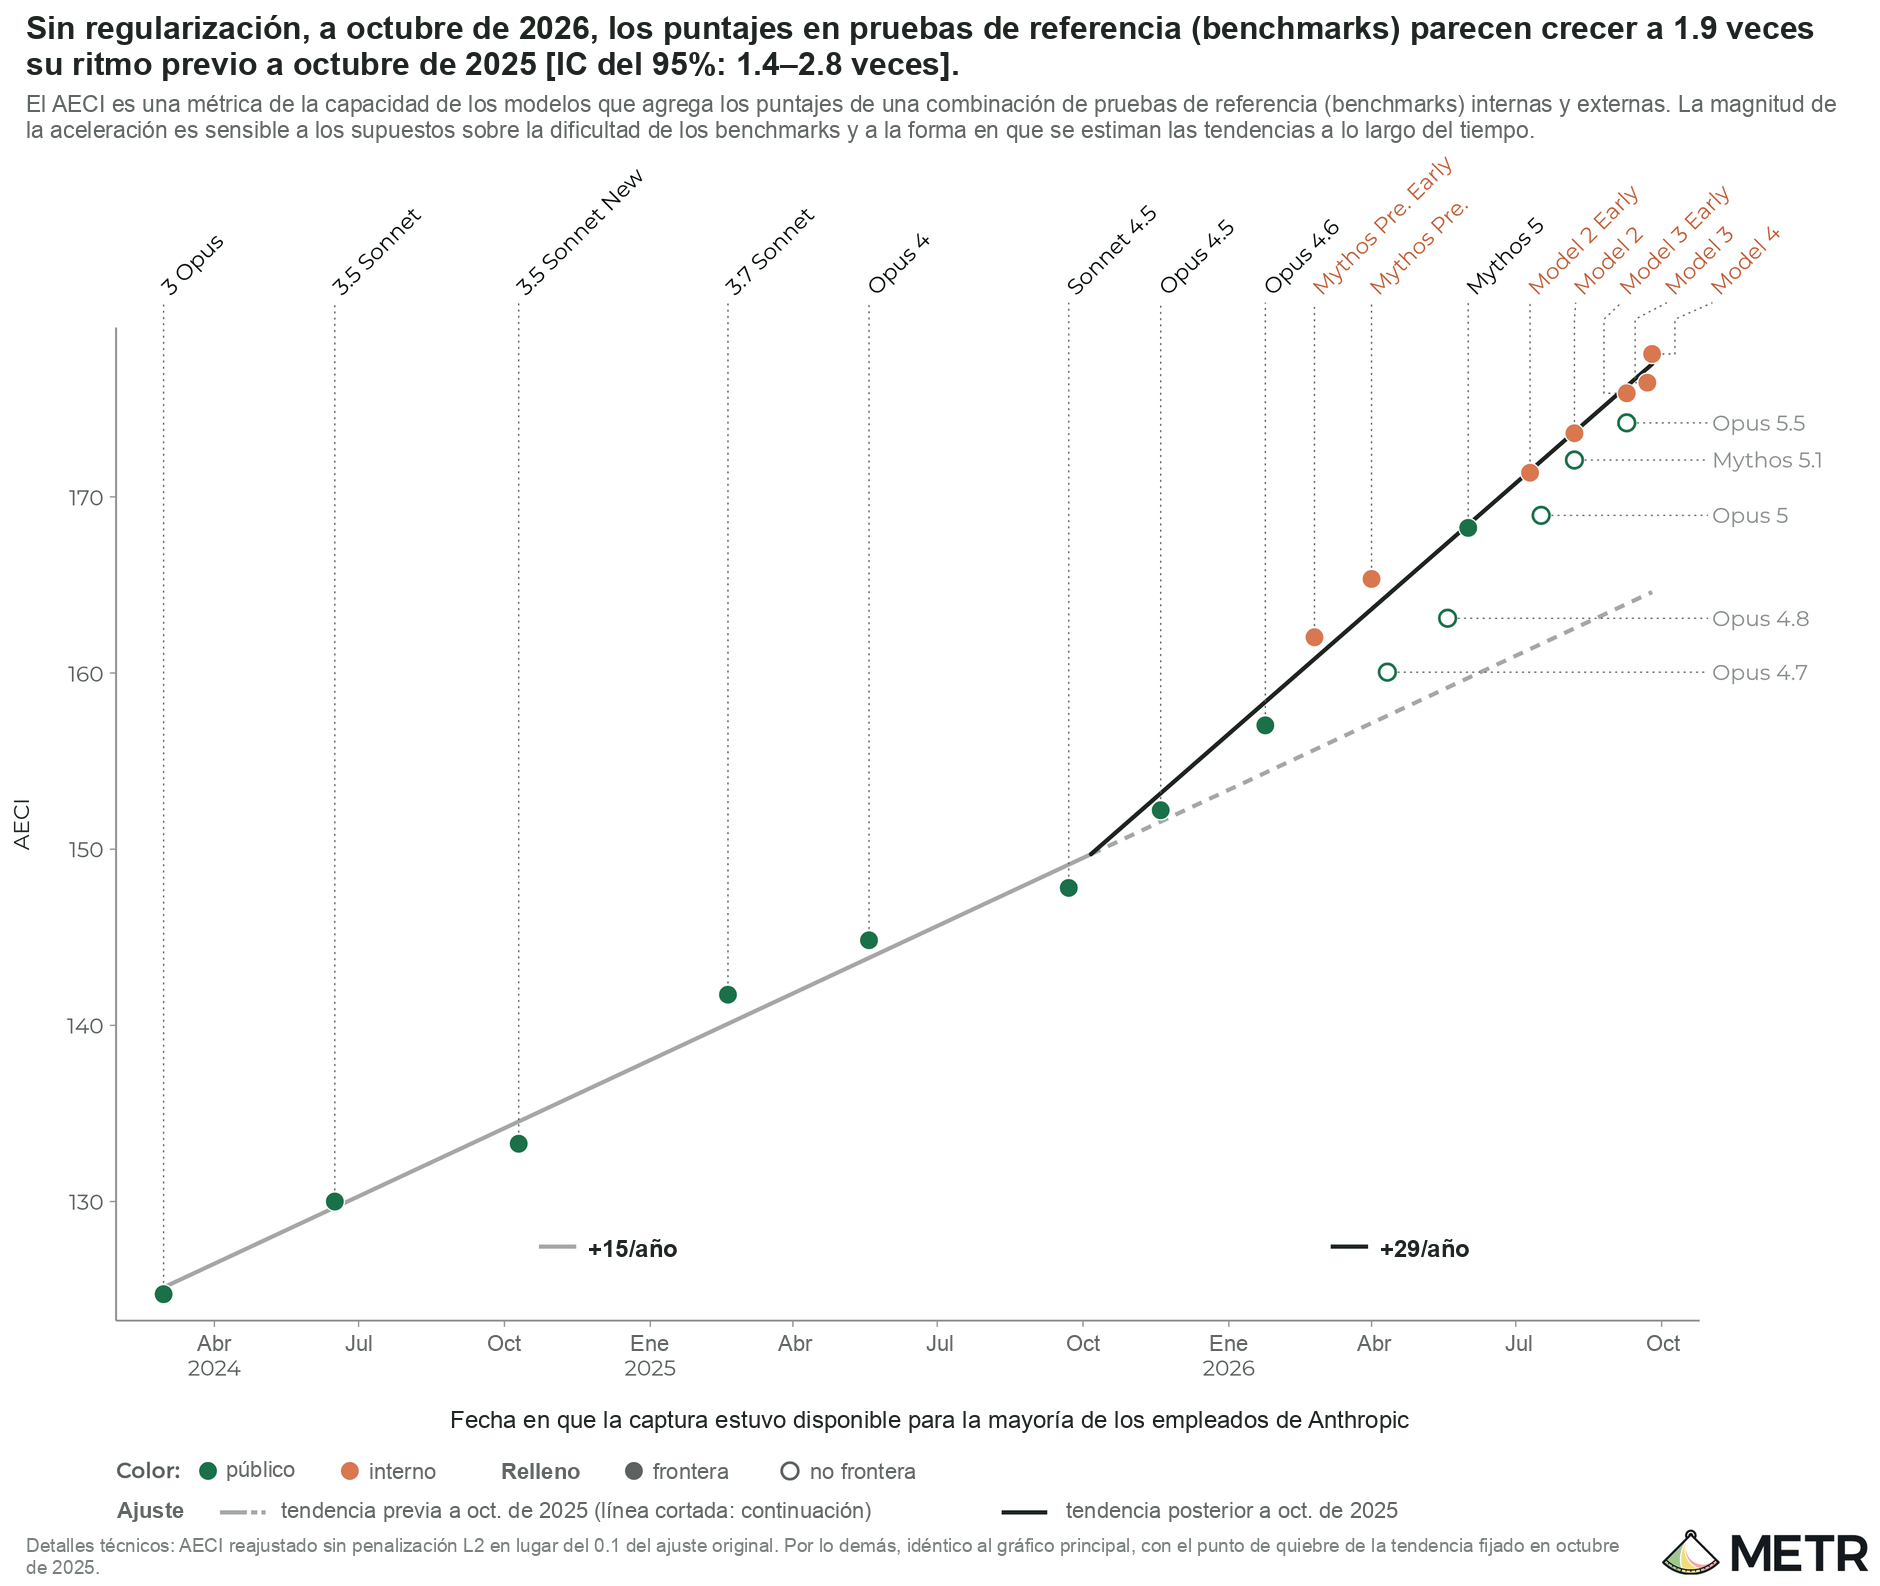 |
| Reorientar la penalización L2 en una tendencia temporal lineal en lugar de hacia 0: el puntaje de capacidad de cada modelo y la dificultad de cada prueba de referencia (benchmark) se desplazan hacia una recta según su fecha de lanzamiento. La capacidad de discriminación de cada benchmark se acerca a 1. | 1.9 veces [1.4–2.8] | 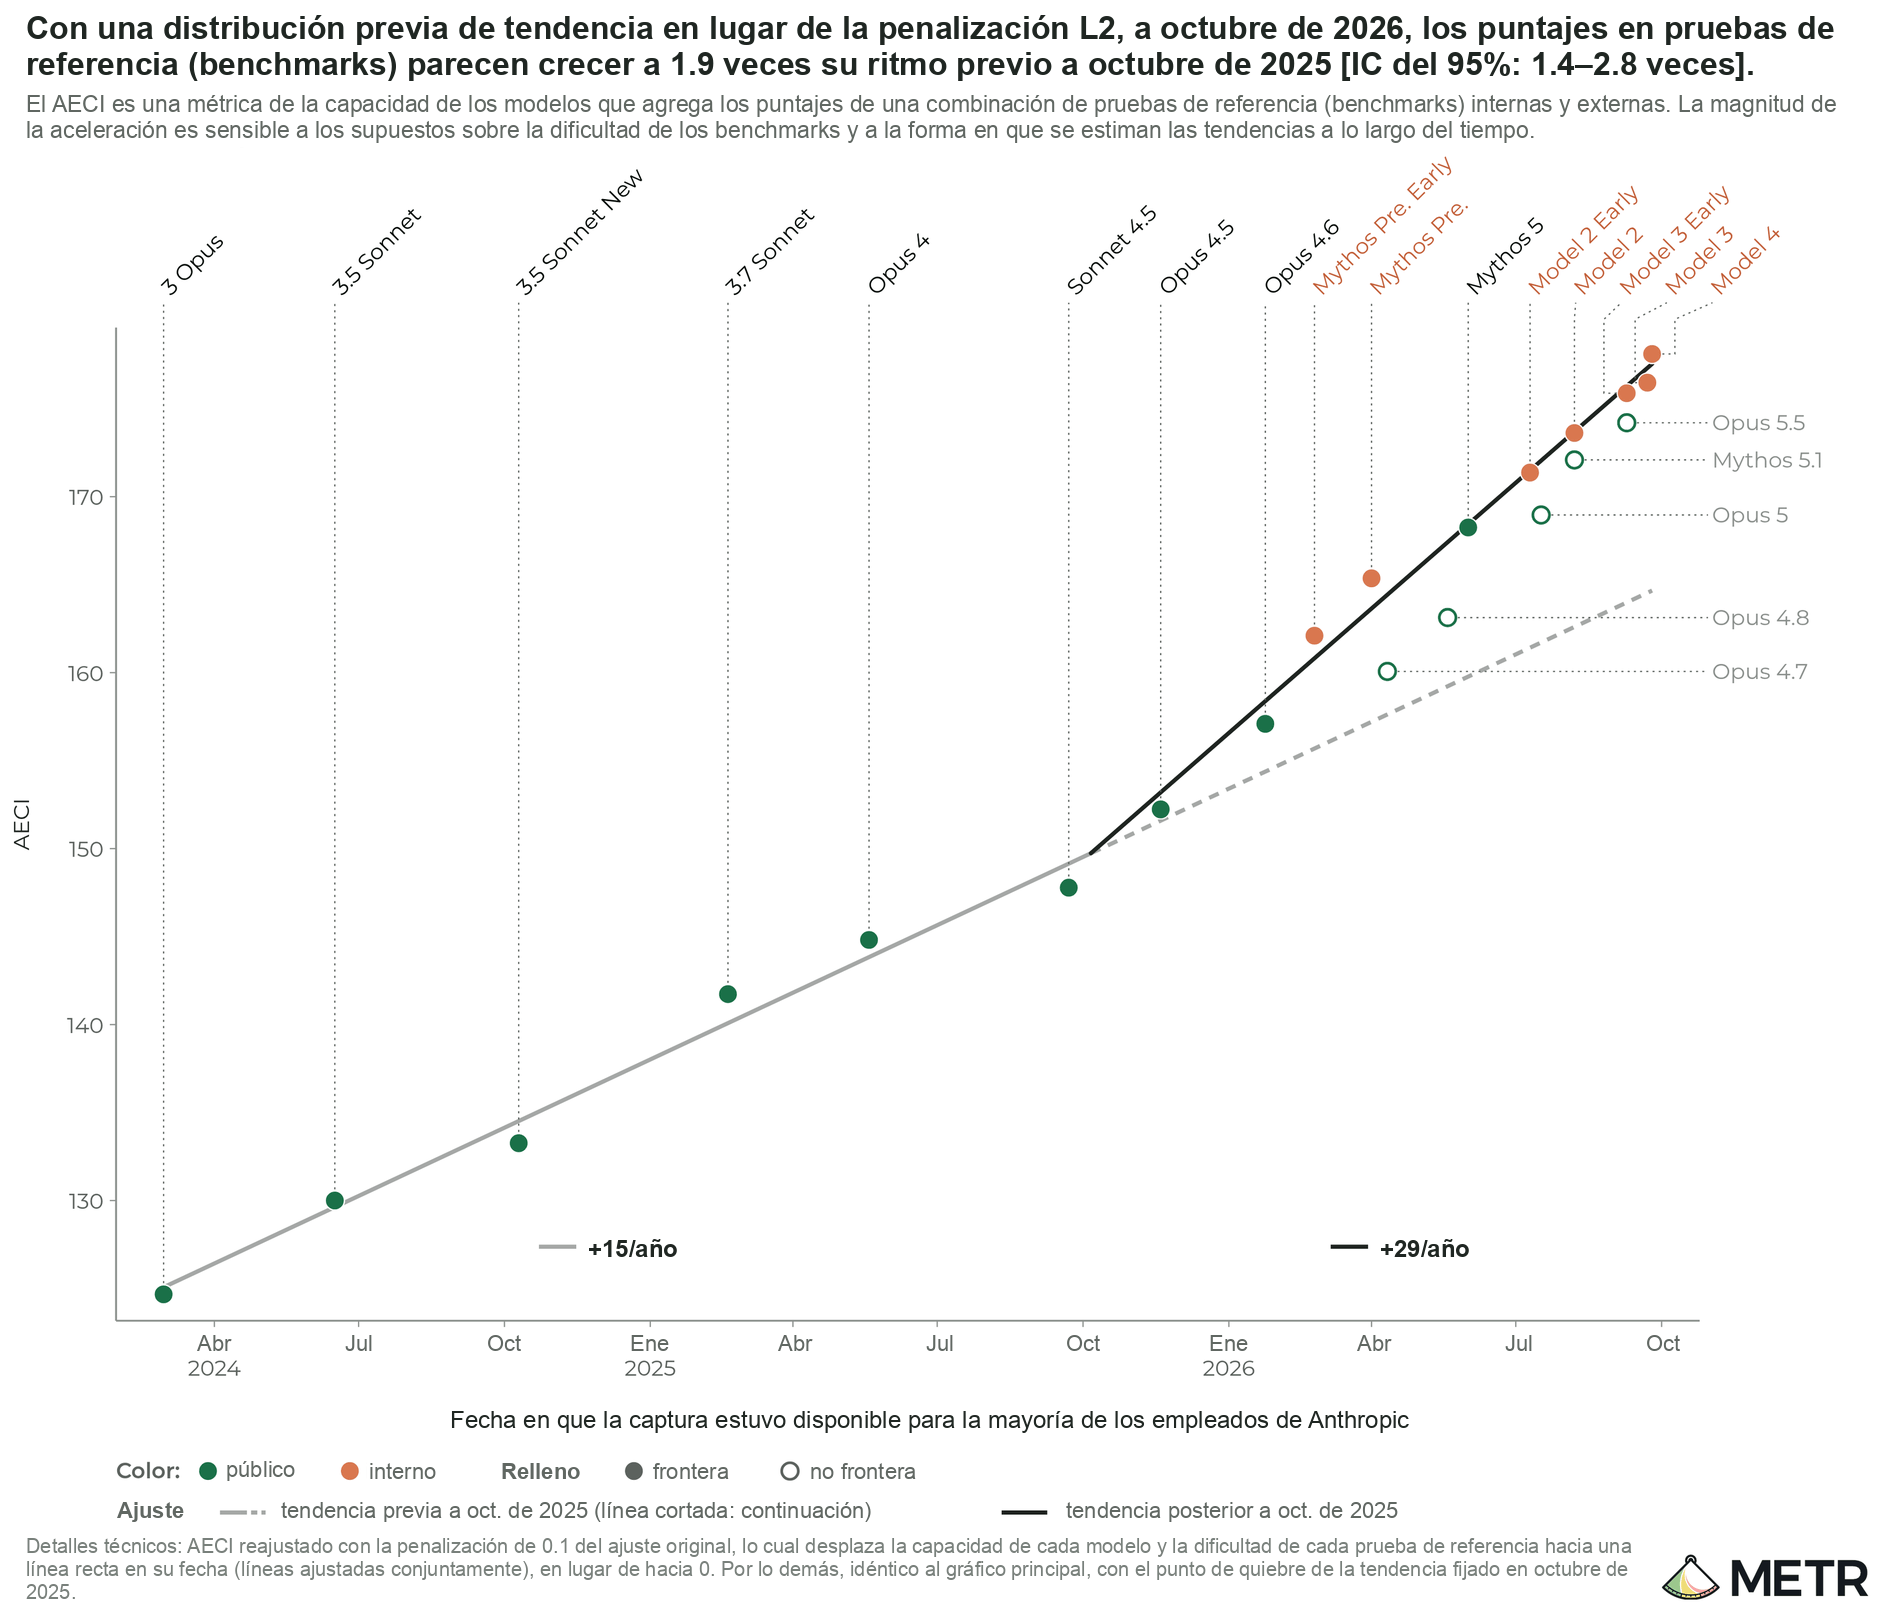 |
Robustez: AECI muestra una menor aceleración cuando incluimos modelos que no son de Anthropic.
Si tomamos nuestros resultados principales del AECI y graficamos todos los modelos de frontera en lugar de solo los de Anthropic, estimamos un menor grado de aceleración.
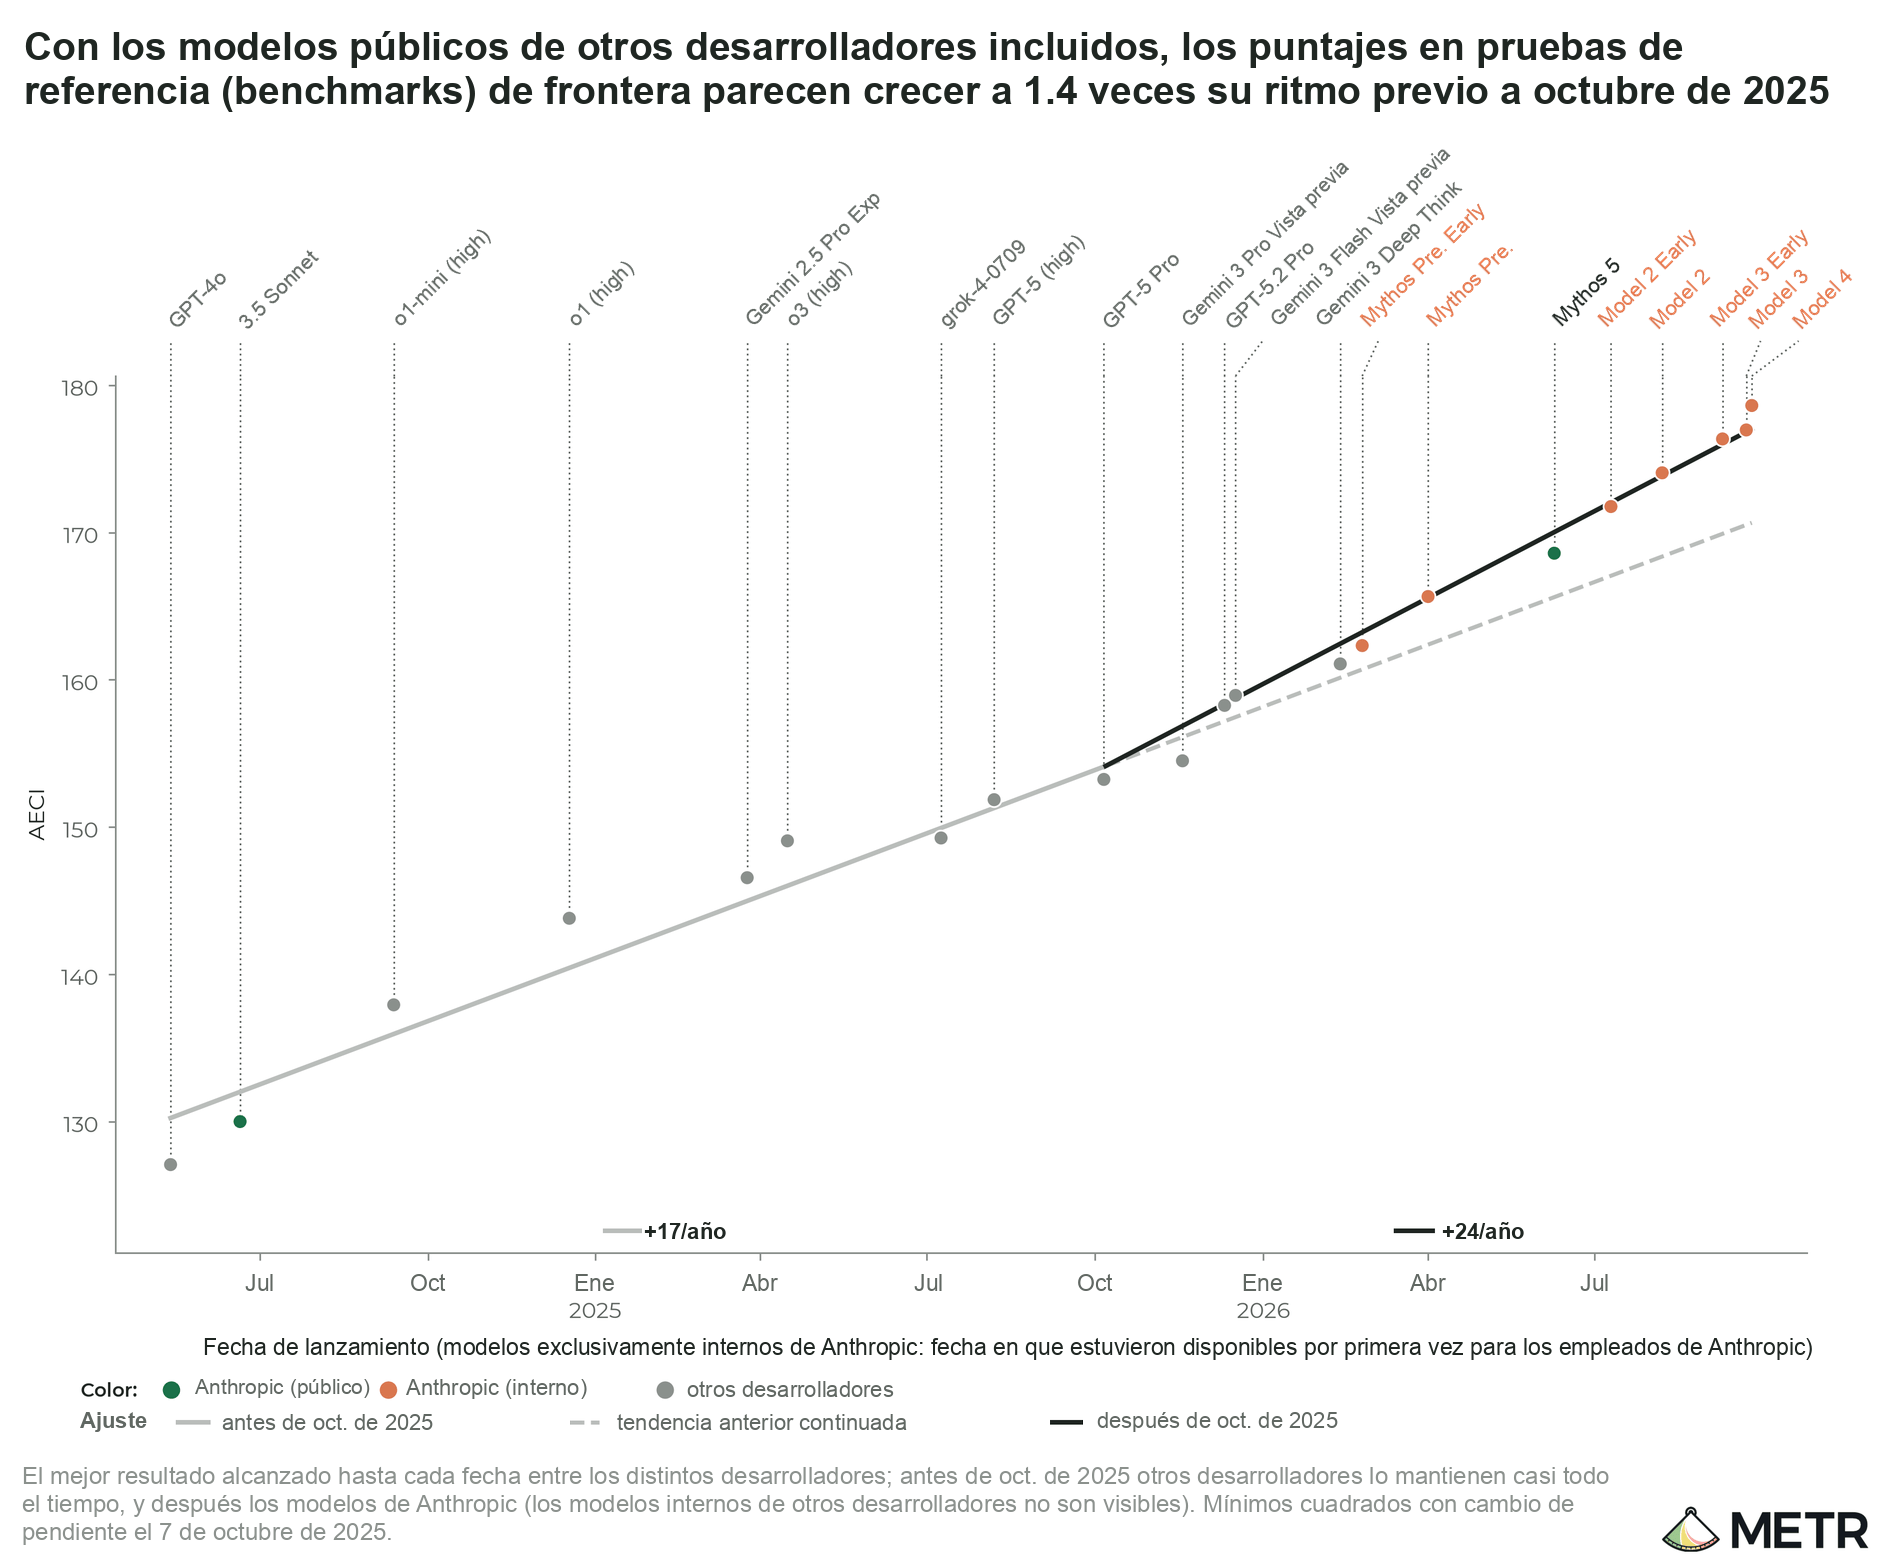
Cabe notar que la tendencia histórica se estima principalmente a partir de modelos que no son de Anthropic, mientras que la tendencia actual se estima, en su mayor parte, a partir de modelos de Anthropic.
Hay un par de interpretaciones plausibles de estos resultados:
- En 2025, los modelos de Anthropic se situaban por debajo de la frontera, por lo que su progreso histórico hasta ese año se vio subestimado. En consecuencia, las cifras de aceleración de 1.9 veces que se presentan en el resto del informe están sobrestimadas, y un valor de 1.4 veces resulta más preciso.
- Si los modelos de Anthropic están menos optimizados para las pruebas de referencia (benchmarks) que otros modelos, esto podría implicar que la tendencia histórica está sobrestimada, ya que los puntos anteriores están más sobreajustados a estos benchmarks. Por consiguiente, la aceleración de 1.4 veces del gráfico anterior estaría subestimada, y el valor de 1.9 veces que citamos en otras partes del informe se acercaría más a la realidad.
Los nuevos modelos internos hacen que un cambio permanente de pendiente parezca más plausible que un salto aislado con Mythos Preview.
Fichas de sistema (system cards) previas de Anthropic han planteado la hipótesis de que hubo un salto aislado de capacidades con Mythos Preview, tras lo cual se retomó la tendencia previa. Los modelos recientes hacen que esta hipótesis parezca menos probable que un cambio permanente de tendencia.
Comparando nuestras estimaciones de AECI con varias otras estimaciones públicas.
El siguiente gráfico compara nuestra estimación de la aceleración con varias estimaciones públicas de la misma aceleración.
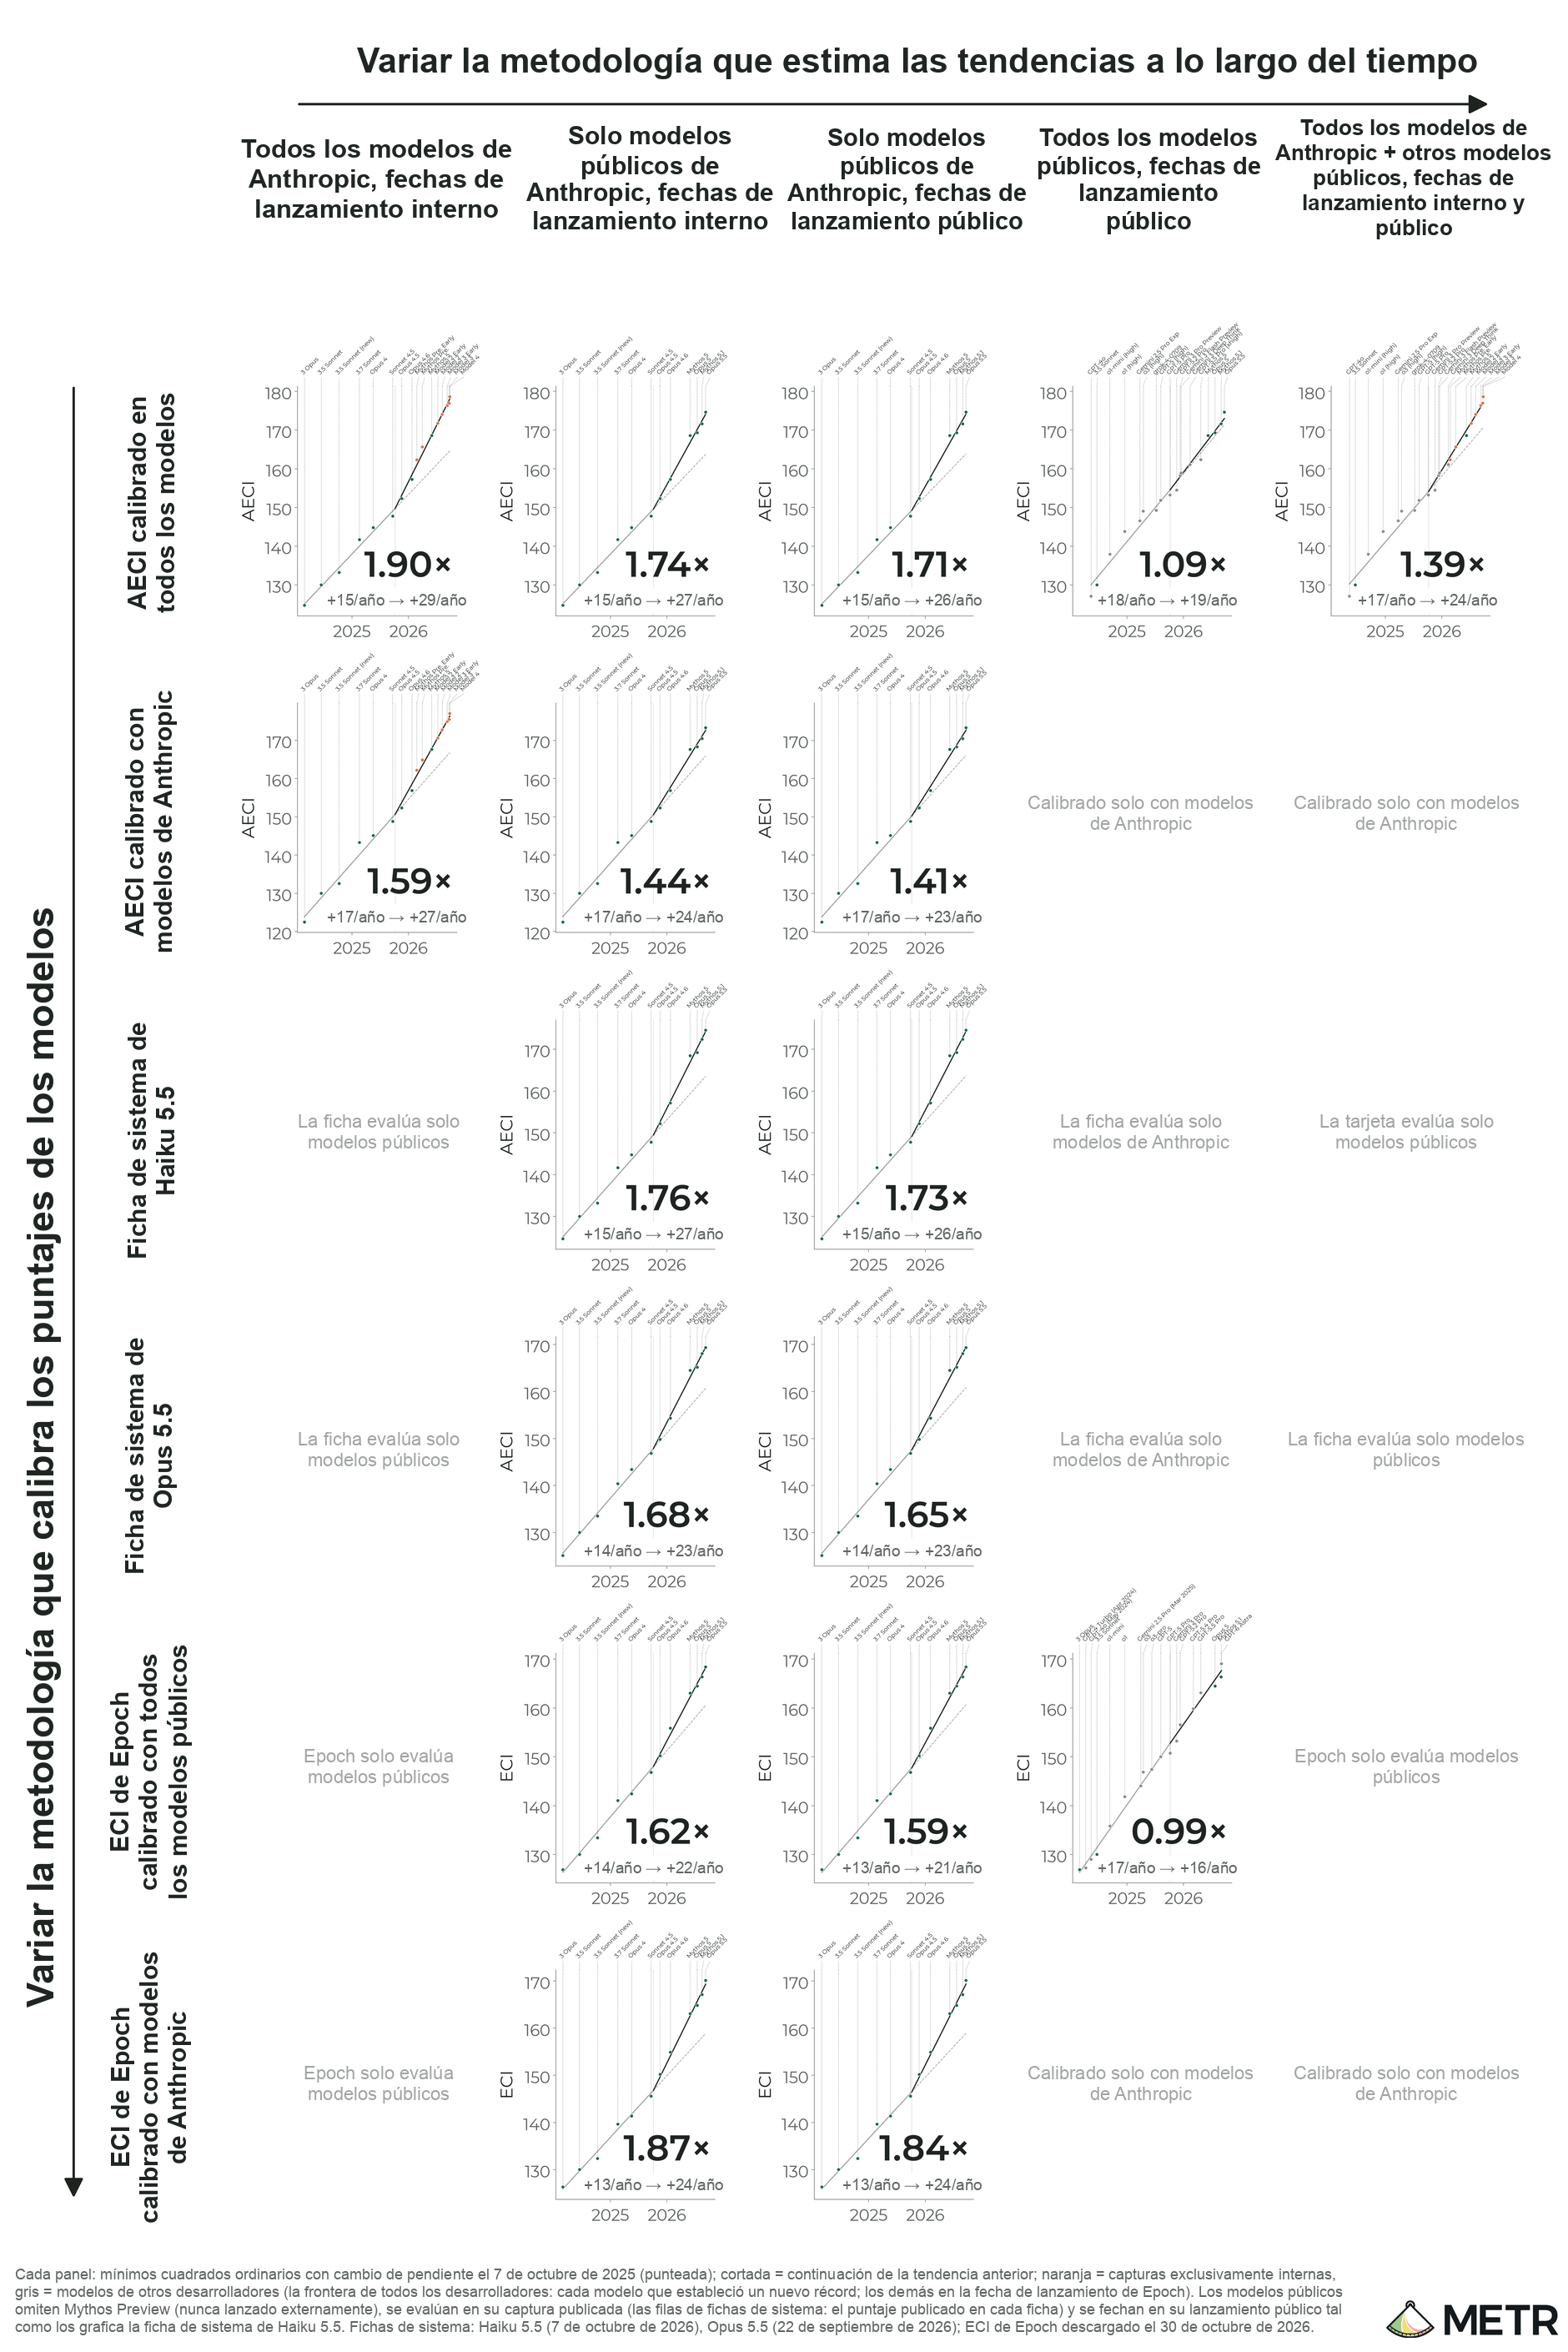
Las filas representan distintas metodologías para calibrar los puntajes (A)ECI de cada modelo; por ejemplo, cambiando las pruebas de referencia (benchmarks) o qué modelos se incluyen en la calibración de los puntajes. Las columnas representan distintas metodologías para convertir esos puntajes en una aceleración a lo largo del tiempo; por ejemplo, seleccionando un subconjunto de modelos, cambiando las fechas de lanzamiento, etcétera.
Nuestras principales conclusiones son las siguientes:
- La diferencia más importante entre el lanzamiento más reciente de Anthropic, la ficha técnica del modelo (system card) de Haiku (aceleración de 1,7 veces), y nuestra estimación (aceleración de 1,9 veces) es que nosotros incluimos los modelos recientes de Anthropic que son de uso exclusivamente interno.
- Las diferencias más importantes entre el ECI y nuestras estimaciones son que nosotros calculamos la tendencia en el tiempo usando solo los modelos de Anthropic y la inclusión de los modelos internos recientes de Anthropic que son de uso exclusivamente interno.
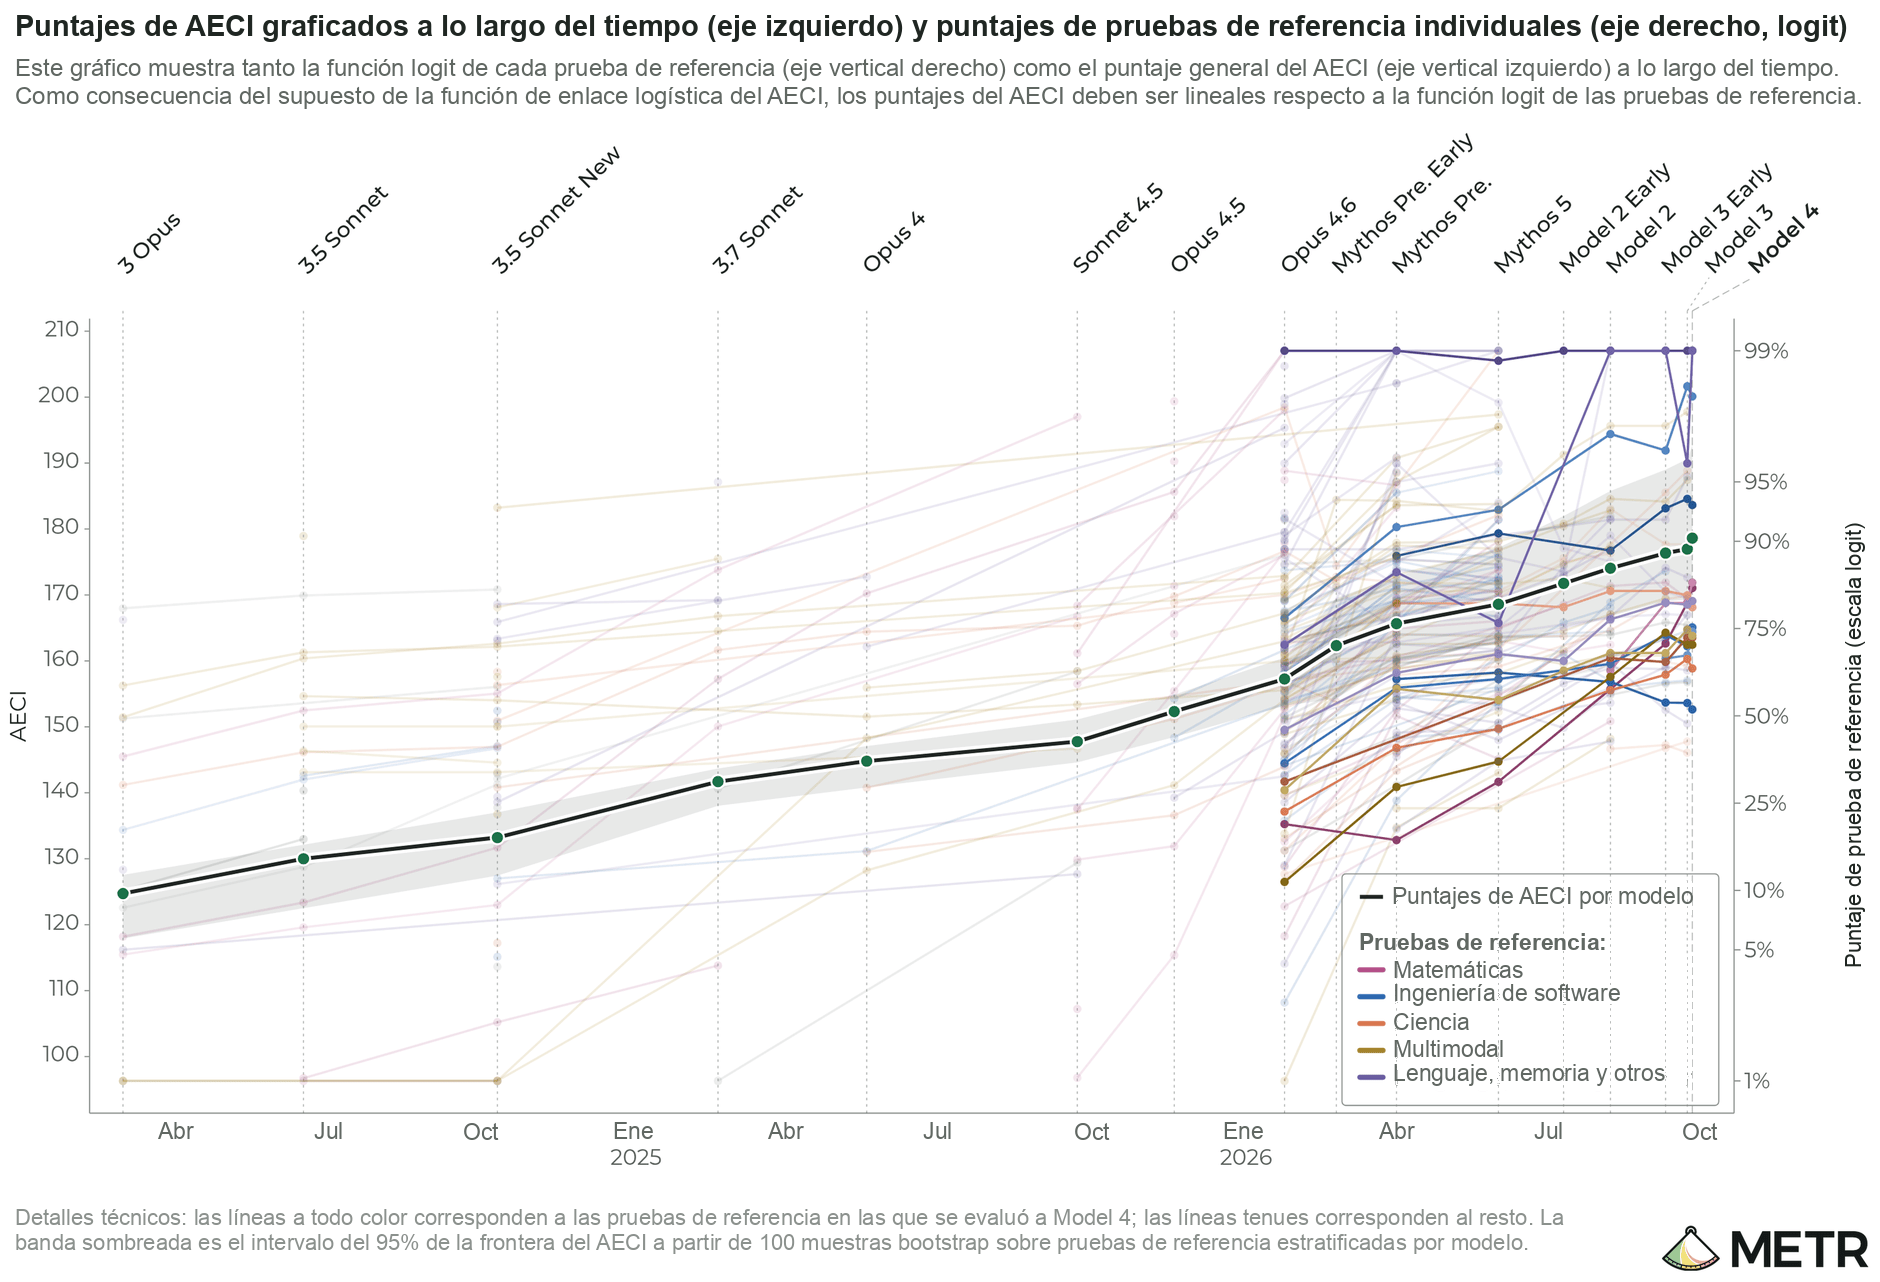
Model 4 alcanza >50% en todas sus pruebas de referencia (benchmarks).
El siguiente gráfico muestra todos los puntajes en pruebas de referencia (benchmarks) de los modelos de frontera incluidos en el AECI, en escala logit, lo que implica que deberían evolucionar de forma lineal con el puntaje AECI latente de cada modelo (si se cumple el supuesto de la función logística). Las líneas destacadas corresponden a las 15 pruebas de referencia (benchmarks) usadas para Model 4. Cabe notar que Model 4 supera el 50% en todas ellas. Se observa que la distribución de dificultad de los benchmarks era muy distinta hace apenas 9 meses: Opus 4.6 tenía muchos benchmarks en los que obtenía menos del 50%. Esta falta de benchmarks difíciles para Model 4 nos genera cierta preocupación sobre nuestra capacidad de medir el AECI ahora y en el futuro.
La mayoría de las pruebas de referencia (benchmarks) usadas para Model 4 parecen razonablemente lineales en escala logit.
Una preocupación específica al medir la aceleración con AECI son las pruebas de referencia (benchmarks) con muchas tareas defectuosas, o aquellas en las que la dificultad de las tareas sigue una distribución de colas pesadas. La función de enlace logística supone que la dificultad de las tareas tiene colas exponenciales. Si la distribución tuviera colas pesadas, pasar de 98% a 99% requeriría más puntos de AECI que pasar de 80% a 90% (la función logística supone que ambos saltos son aproximadamente igual de difíciles). Una distribución de dificultad de tareas con colas pesadas podría llevarnos a subestimar la aceleración. Como se describió antes, usar funciones de enlace cauchit o log-log (que modelan las últimas tareas de un benchmark como especialmente difíciles) da estimaciones de aceleración de 2.8 y 2.9 veces, respectivamente.
Realizamos una prueba de diagnóstico simple para evaluar la dificultad de las tareas. Para cada una de las 15 pruebas de referencia (benchmarks) usadas para Model 4 en el AECI, comparamos el AECI estimado de cada modelo con su puntaje en ese benchmark en escala logit. Si se cumplen los supuestos del AECI, es decir, si la dificultad de las tareas sigue una relación logística con la habilidad latente del modelo, esperaríamos que cada gráfico fuera lineal. Si hay muchas tareas defectuosas o una distribución de dificultad con colas pesadas, esperaríamos que estos ajustes fueran cóncavos. En cambio, esperaríamos un ajuste convexo si hubiera una proporción desmedida de tareas fáciles.
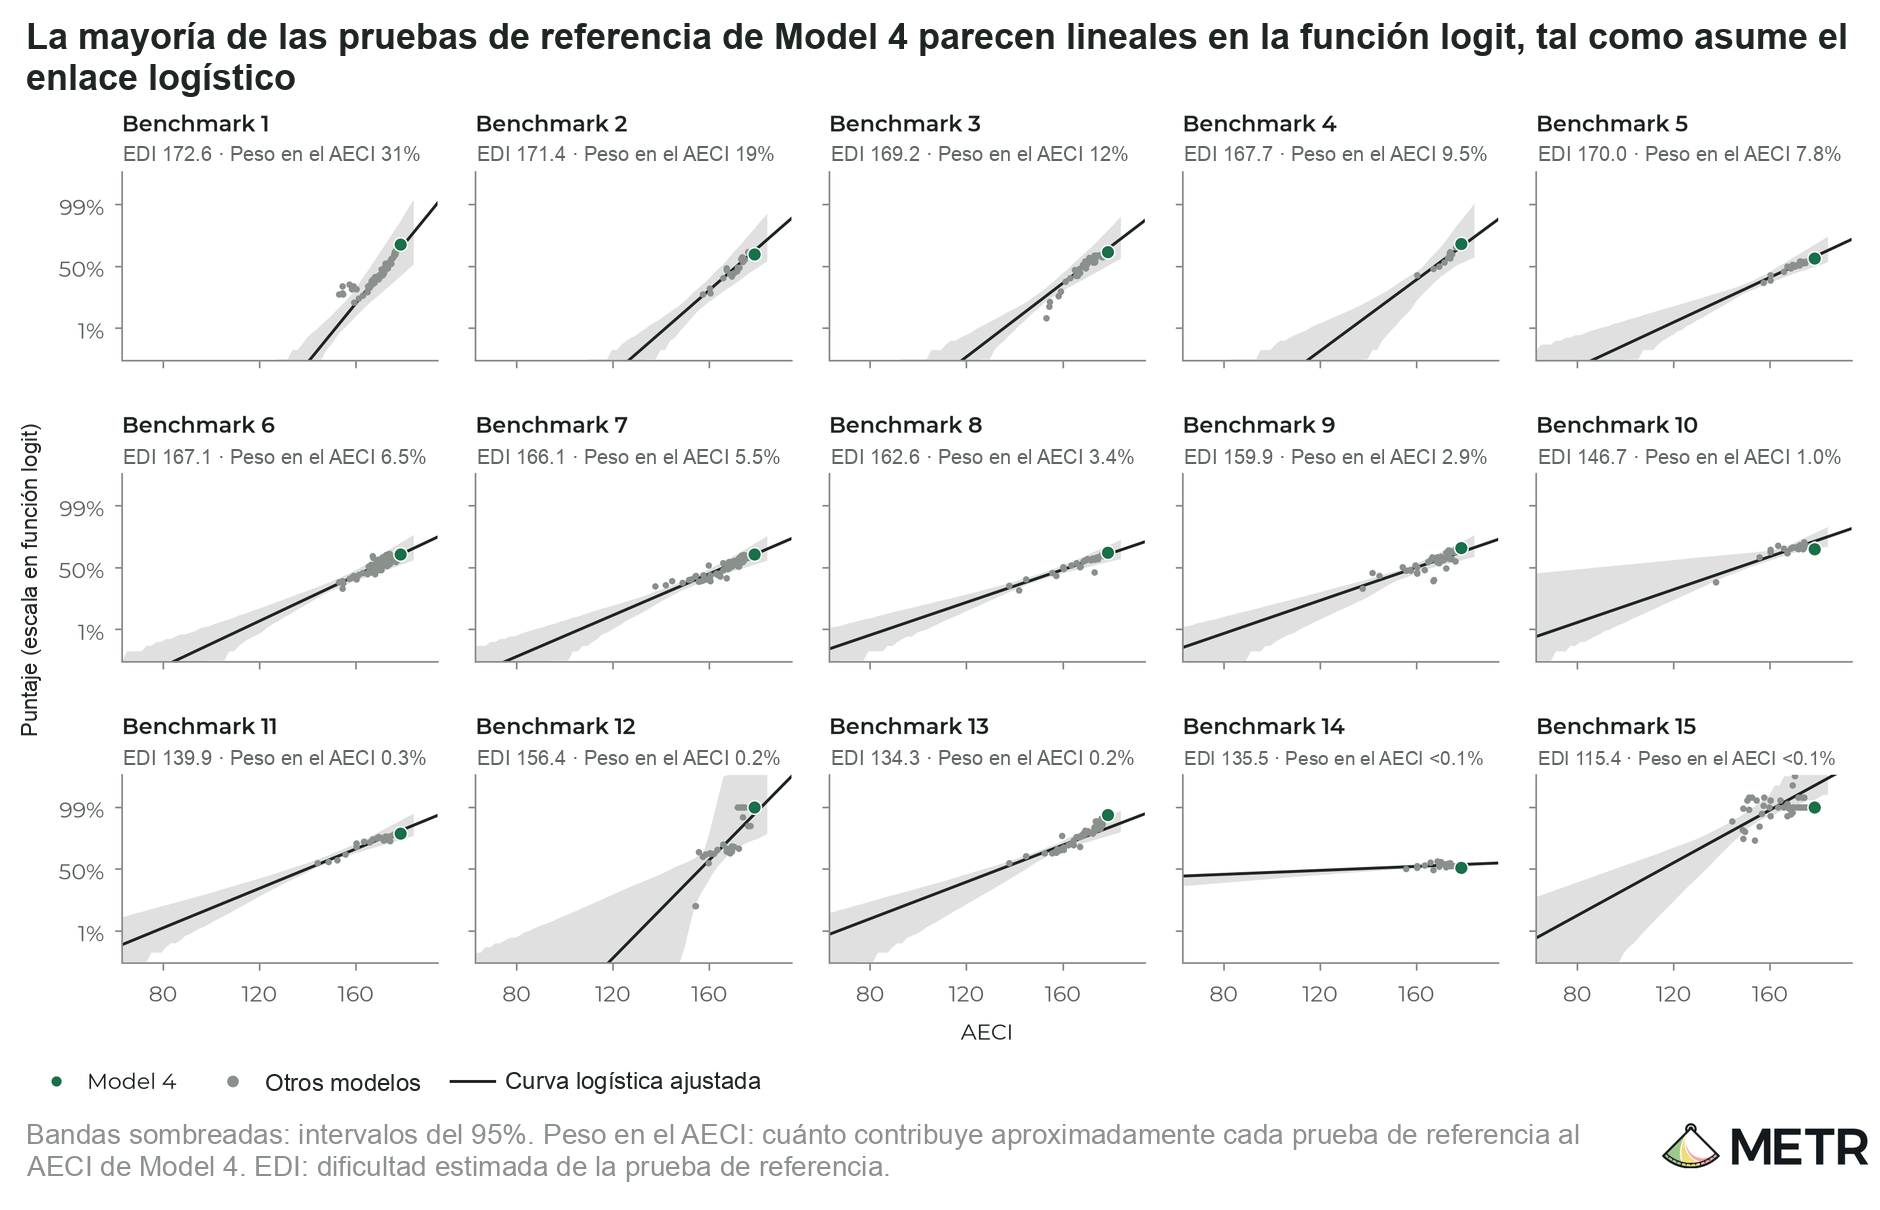
Notamos que 3 de las 15 pruebas de referencia (benchmarks) tienen ajustes notoriamente planos o cóncavos. Al volver a estimar el AECI de todos los modelos sin esos 3 benchmarks sospechosos, el puntaje de Model 4 sube 1 punto, de 178.6 a 179.7. Por lo tanto, creemos que hay cierta evidencia débil de que las colas pesadas llevan a subestimar la aceleración, pero la magnitud no es grande.
La cantidad de tokens por prueba de referencia (benchmark) podría ser demasiado baja.
Gastar pocos tokens en las pruebas de referencia (benchmarks) podría sesgar a la baja las estimaciones del crecimiento de las capacidades si los modelos posteriores muestran mayores retornos al gasto de tokens (es decir, si los primeros modelos presentan un estancamiento en relación con el gasto, mientras que modelos posteriores alcanzan retornos elevados).
Anthropic nos compartió datos sobre los tokens usados en las pruebas de referencia (benchmarks) del AECI. Una tarea típica (un solo intento) usó alrededor de 2.5 millones de tokens de entrada y 72 mil de salida en los benchmarks internos, y cerca de 10 millones de entrada y 94 mil de salida en los benchmarks de programación agéntica. Como comparación aproximada, Epoch AI usa alrededor de 0.5 millones de tokens de entrada y 10 mil de salida en una tarea típica de algunos benchmarks públicos (GPQA, AIME, SWE-bench), y 1 millón de entrada y 8 mil de salida en un benchmark específico de programación agéntica (SWE-bench). Como otra comparación aproximada, METR usa alrededor de 650 mil tokens de salida en sus benchmarks más recientes de software de larga duración, aunque es posible que la forma de contabilizar los tokens no sea comparable.
Además, sería útil observar las curvas de rendimiento en función del gasto para cada modelo, es decir, los puntajes obtenidos con distintos niveles de gasto. Las fichas de sistema de Anthropic sí reportan curvas de gasto para algunos benchmarks (por ejemplo, la ficha de sistema de Opus 5.5). Hay evidencia reciente de que es posible usar cantidades muy grandes de cómputo de inferencia para resolver problemas difíciles (por ejemplo, Navier–Stokes). En general, estimamos que los puntajes AECI de cada modelo podrían aumentar en unos pocos puntos si se aumentara aún más la cantidad de tokens de inferencia. Nuestra estimación aproximada es que esto tendría retornos similares entre modelos, por lo que el grado de aceleración estimado sería el mismo. Sin embargo, no lo investigamos en profundidad, y es posible que los modelos recientes tengan mejores propiedades de escalado de tokens.
Una aceleración en los puntajes de las pruebas de referencia (benchmarks) podría no reflejar una aceleración del impacto en el mundo real.
Lo ideal sería conocer el valor real, o el impacto potencial, de cada modelo, no sus puntajes en pruebas de referencia (benchmarks). Si el impacto en el mundo real mantiene una relación suave con los puntajes en benchmarks, deberíamos esperar que una aceleración del AECI vaya acompañada de una aceleración equivalente de sus efectos en el mundo real.5
Hay varias razones por las que la aceleración en el AECI podría no reflejar una aceleración en el impacto de las capacidades de los modelos en el mundo real:
- Si el impacto en el mundo real es una función convexa de los puntajes en pruebas de referencia (benchmarks) (por ejemplo, si el impacto depende de superar un umbral de capacidad), el AECI subestimaría la aceleración real. En algunos ámbitos hemos visto un aumento sostenido en los puntajes de los benchmarks acompañado de aceleraciones repentinas de su impacto en el mundo real, como en la tasa de descubrimientos en ciberseguridad o matemáticas (ref).
- Si las pruebas de referencia (benchmarks) del AECI cubren solo una parte de las capacidades, y el impacto en el mundo real tiene rendimientos decrecientes en esas capacidades, el AECI podría sobrestimar la aceleración real. Por ejemplo, supongamos que el AECI mide principalmente la capacidad de un modelo para resolver problemas formales, pero que esa capacidad tiene rendimientos decrecientes en el mundo real. En ese caso, podríamos observar una aceleración del AECI sin una aceleración del impacto en el mundo real.
En resumen, estamos seguros de que ha habido al menos una aceleración moderada en el crecimiento de los puntajes de las pruebas de referencia (benchmarks). Sin embargo, creemos que existe un riesgo considerable de que la aceleración del AECI no se traduzca de forma directa en una aceleración del impacto en el mundo real.
Evidencia de la aceleración mediante IA
Existe evidencia considerable de una aceleración gracias a la IA.
Definimos la aceleración mediante IA como la proporción entre la producción de un miembro del personal o de un equipo con y sin IA, aunque cabe señalar que esa producción suele ser difícil de medir o definir.
A continuación, examinamos brevemente la evidencia general sobre aceleración mediante IA y concluimos lo siguiente:
- Existe cierta evidencia que indica una gran aceleración, aunque su magnitud exacta es altamente incierta.
- Actualmente, las contribuciones que hace la IA de forma totalmente autónoma a la I+D en IA no representan una parte importante del progreso general, pero podrían llegar a serlo en un futuro cercano.
Supresiones en esta sección.
Anthropic suprimió la evidencia del aumento de aceleración por IA que estaba directamente relacionada a partes específicas de su proceso de entrenamiento de modelos, así como nuestro análisis sobre cómo la evidencia en esta sección se relacionaba con nuestras estimaciones de aceleración en distintas partes de ese proceso. Además, se censuró una afirmación sobre el uso de cómputo para inferencia en Anthropic, porque estaba expresada en unidades de cómputo y no la consideramos lo bastante informativa como para pedir que se expresara en función de precios de la API. También suprimieron detalles confidenciales de las citas de investigadores que aparecen más adelante.
Las declaraciones informales sobre mejoras han ido aumentando de forma constante.
Anthropic compartió datos provenientes de diversas fuentes, basados en declaraciones del propio personal, sobre la mejora en el rendimiento atribuido a la IA. Los datos más recientes provienen de una serie de encuestas en Slack, en las que el personal utiliza reacciones para indicar cuánto estiman que ha aumentado su velocidad de trabajo gracias al modelo más reciente disponible en ese momento. Consideramos que esto es evidencia muy débil: suponemos que las respuestas provienen de un subconjunto no representativo del personal y que reflejan una valoración realizada con poco esfuerzo. Además, existen indicios de que las estimaciones del aumento de productividad obtenidas mediante encuestas de autoevaluación pueden sobrestimar su impacto real en la productividad.
Sin embargo, observamos un crecimiento sostenido en estas autoevaluaciones, como se muestra en el gráfico de abajo. Con el modelo interno más capaz de octubre de 2026, el aumento promedio de productividad declarada fue de alrededor de 12 veces.
Estas estimaciones propias han crecido, pero es difícil saber cómo extrapolarlas. El gráfico de arriba ajusta el aumento de productividad en función del tiempo, mediante un ajuste log-lineal y uno superexponencial.
Las entrevistas respaldan, en términos generales, que la IA ha duplicado la tasa de crecimiento.
Tanto METR como Anthropic entrevistaron a numerosos investigadores (véanse los detalles en la siguiente sección). Usamos Claude para clasificar las citas en función de si respaldan la idea de que la IA permite una aceleración del doble o más en su ámbito de trabajo, en comparación con trabajar sin IA. Interpretamos los resultados como ligeramente a favor de una aceleración de 2 veces o más:
- Sí: 2
- Se inclina por el sí: 3
- En el límite/poco claro: 4
- Se inclina a no: 0
- No: 2
Las citas, con datos sensibles suprimidos, se encuentran en la siguiente sección:
Existen indicios de señales de vida para contribuciones completamente autónomas en algunas partes del proceso.
Además de potenciar el trabajo humano, también nos interesa la I+D en IA realizada de forma autónoma. Entendemos que la IA aún no es capaz de hacer contribuciones sumamente significativas y totalmente autónomas a las partes más importantes del proceso de entrenamiento de modelos. Sin embargo, los investigadores describieron importantes “señales de vida” que indican que esas contribuciones podrían producirse pronto, aunque con una variación considerable según el área. Detalles adicionales fueron suprimidos. Esta evidencia proviene de:
- Varias entrevistas con investigadores que trabajan en automatizar distintas partes del proceso de entrenamiento.
- Informes internos sobre el grado de automatización en distintas partes de la cadena de procesos.
- Análisis cuantitativos del porcentaje de tareas en un flujo de trabajo pertinente que fueron desarrolladas por humanos o por IA.
Citas de entrevistas sobre la aceleración de la IA
El personal de Anthropic y de METR entrevistó a varios investigadores sobre la aceleración de la I+D gracias a IA en su trabajo. Las entrevistas varían en extensión y profundidad, pero suponemos que los investigadores les dedicaron considerablemente más tiempo del que emplearon en responder a las encuestas mencionadas anteriormente.
Para clasificar las entrevistas, le pedimos a Claude que revisara todas nuestras notas, extrajera las citas relevantes y las codificara como favorables a una aceleración de más de 2 veces gracias a la IA en el área de trabajo del entrevistado, como ambiguas o si apuntan en contra. Cada fila de la tabla siguiente corresponde a una sola persona y a todas sus citas relevantes. Cabe señalar que cada entrevistado muchas veces interpretó la pregunta de forma algo distinta: por ejemplo, si se refería a un aumento de productividad acumulado o instantáneo, o si hablaba del aumento de productividad personal o el de toda la organización.
Usamos el siguiente prompt:
“¿Puedes revisar todas las pestañas de entrevistas así como todos los documentos de entrevistas relevantes que se encuentran fuera de este documento de Google? [contexto suprimido]. ¿Puedes hacer una tabla en la que cada fila corresponda a una persona y en la que después juntamos todas sus citas? Luego, por favor, agrega una columna con tu valoración general indicando si esta persona respalda una aceleración de productividad en su trabajo de más de 2 veces gracias a Claude.”
| Persona | Citas | ¿Respalda una aceleración de productividad de más de 2 veces gracias a Claude en su área de trabajo? |
|---|---|---|
| Investigador A | “Sin duda podría respaldar una aceleración de más de 2 veces.” — Notas de entrevistas de METR “Mi impresión como miembro interno es que el factor más grande, por mucho, es la aceleración de los modelos.” — Notas de entrevistas de METR “La aceleración mediante IA tiene un impacto mayor que todos los demás factores.” — Notas de entrevistas de METR “Ahora, el único cuello de botella reside en las ideas y la capacidad de cómputo, el código ya no supone un obstáculo.” — Notas de entrevistas de METR “Respaldaría sin duda más de 2 años de progreso en 1 año, y no creo que 4 sea una locura.” — Notas de entrevistas de METR “Creo que hay algo de verdad en la idea de que ‘simplemente nos hemos esforzado más’, pero, en mi opinión, la mayor parte del efecto se debe a los modelos más recientes.” — Notas de entrevistas de METR “Alrededor de una reducción del 80% en el tiempo que transcurre entre una idea y su experimentación, otro 20% se debe a una combinación de factores: cometer menos errores y poder medir cosas difíciles que, anteriormente, habrían requerido demasiados trabajos individuales.” — Notas de entrevistas de METR “Creo que hubo un avance moderado cuando fue lo suficientemente capaz como para poder programar; y un avance importante con Opus-4.5/Opus 4.6; y un avance aún mayor con mythos-preview.” — Notas de entrevistas de Anthropic |
Sí |
| Investigador B | “Resulta difícil negar que estoy siendo tres veces más productivo. Siento como si contara con investigadores posdoctorales y estudiantes de posgrado, y estamos trabajando en un proyecto de mayor envergadura. Creo que la explicación más sencilla es Claude—al menos, desde mi perspectiva individual, esto me parece algo sensato.” — Notas de entrevista de METR | Sí |
| Investigador C | “En mi opinión, este es probablemente el factor más importante. Cuando las personas presentan experimentos, lo más habitual es que remitan a un hilo de [andamiaje de un agente (agent scaffold)]. El costo operativo de la experimentación tiende a cero con gran rapidez.” — Notas de entrevista en Anthropic “Creo que CC [Claude Code] ya era lo suficientemente bueno con Opus 4.5 para implementar la mayoría de las ideas, incluso antes de la versión mythos-preview.” — Notas de entrevista en Anthropic |
Tiende a sí |
| Investigador D | “Es simplemente mucho más fácil [realizar] muchos experimentos de [suprimido] que antes habrían tomado días. La gente no prueba cosas de [suprimido] porque implementar cada idea toma 1 o 2 días, pero ahora es prácticamente gratis con mythos-preview.” — Notas de entrevista en Anthropic “Personalmente, creo que esto supone un gran impulso y me ha llevado a probar muchas más ideas.” — Notas de entrevista en Anthropic “En una escala lineal, aproximadamente cero aumento antes de Opus 4.6/Opus 4.5; cierto aumento, aunque pequeño, con esos modelos; y un gran aumento con mythos-preview + [el andamiaje de un agente]. Yo diría que apenas estamos empezando a hacer una transición completa … y que veremos un aumento sostenido de la pendiente / un punto de inflexión.” — Notas de entrevista en Anthropic |
Tiende a sí |
| Investigador E | “De verdad creo que Claude (Claude Code, [andamiaje de un agente]) ha tenido un impacto bastante significativo. Nos he visto descubrir avenidas muy prometedoras, casi de forma exclusiva debido a que la gente puede lanzar 10 ideas [al andamiaje de agente] y ver cuál funciona.” — Notas de entrevista en Anthropic “Gran parte del trabajo de investigación de [eliminado] consiste simplemente en implementación, vigilancia de los procesos en ejecución, etc. Opus 4.5 en Claude Code ya es bastante útil para esto, aunque en general no pueda hacerlo de principio a fin.” — Notas de entrevista en Anthropic |
Tiende a sí |
| Investigador F | “Entre un 50-80% del cambio de pendiente se debe a Claude.” — Notas de entrevista en Anthropic “El cambio es especialmente notable para este líder de equipo, que puede validar ideas con Claude lo suficiente como para entusiasmar a otra persona, algo que anteriormente le habría resultado totalmente imposible al gestionar un equipo de 10 personas.” — Notas de entrevista en Anthropic (parafraseado) |
Al límite/poco claro |
| Investigador G | “El punto de inflexión coincide con su intuición sobre lo que ha estado ocurriendo. Los dos factores que más han contribuido son la automatización con Claude y la contratación de personal.” — Notas de entrevista en Anthropic (parafraseado) “Claude permite a los investigadores probar muchas cosas rápidamente, aunque la mayoría no funcione. …” — Notas de entrevista en Anthropic |
Poco claro |
| Investigador H | “Creo que es cierto [que] ahora estamos probando muchos más experimentos al mismo tiempo gracias a la ‘claudificación’.” — Notas de entrevista en Anthropic | Poco claro |
| Investigador J | “Antes de Opus-4.5 -> Claude no era útil para código autónomo / Con Opus-4.5 -> por primera vez es útil para código autónomo / Con mythos-preview + [andamiaje de agente] -> por primera vez es útil para experimentos autónomos.” — Notas de entrevista en Anthropic | Poco claro |
| Investigador K | “En mi opinión, [la contratación de personal es] probablemente la razón más importante…” — Notas de entrevista en Anthropic | No |
| Investigador L | “Calcula que entre un 15-20% se debe a la IA. No cree en los aumentos de productividad autodeclarados.” — Entrevista de METR “Mi interpretación preferida: [factor no relacionado con la IA, suprimido].” — Entrevista de METR “(1) Opus 4.5 no podía escribir código; (2) Opus 4.6 podía escribir un poco; (3) Mythos Preview marcó un punto de inflexión pronunciado; (4) Model 2 es otra mejora muy grande en cuanto a la utilidad de estas herramientas.” — Entrevista de METR “Sin duda es cierto que Claude nos ha acelerado… Aunque la tasa de progreso a finales de año será aún más rápida… mi atribución [principalmente no a Claude] y mi incertidumbre se mantienen.” — Entrevista de METR “Uno de los impactos es la aceleración de la ingeniería de software, la cual es sumamente considerable. Definitivamente nos estamos beneficiando de eso en 2026 más que en 2025.” — Entrevista de METR |
No |
Robustez ante manipulación
Creemos que este ejercicio fue razonablemente robusto ante la manipulación.
Al tratarse de una evaluación independiente, es importante que actuemos con la debida diligencia y entendamos qué tan difícil le habría resultado a Anthropic inducirnos a error de manera sistemática; es decir, qué probabilidades existen de que hayamos sido conducidos intencionadamente a una conclusión incorrecta.
Primera debilidad en cuanto a la robustez frente a manipulación: Dependimos de datos provenientes de unos pocos empleados de Anthropic. La mayor parte de nuestra información la recibimos a través de dos miembros del personal técnico; sin embargo, entrevistamos a unos 15 empleados más de Anthropic sobre diversos temas. No detectamos discrepancias entre lo que dijeron nuestros contactos principales y lo que dijeron los entrevistados. Dado que muchos de estos empleados fueron elegidos por nosotros y no por Anthropic, consideramos que habría resultado muy difícil orquestar una situación en la que se nos proporcionara información deliberadamente engañosa.
Segunda debilidad en cuanto a la robustez frente a la manipulación: La mayor parte del análisis dependió de Claude. Claude participó en muchas etapas de este proyecto, por lo que, en principio, podría estar distorsionando nuestra percepción de los datos. Creemos que Claude tuvo un rol importante en:
- la mayor parte de la recopilación y el análisis de los datos que recibimos,
- la redacción de buena parte de los documentos que recibimos,
- la mayor parte de nuestro propio análisis.
No detectamos discrepancias importantes que indicaran un sesgo sistemático, incluso al compararlas con las entrevistas a personas. Sospechamos que no se trata de un riesgo significativo.
En general, consideramos que es muy poco probable que Anthropic intentara engañarnos de forma deliberada. Sin embargo, creemos que un mayor acceso nos permitiría aumentar el grado de robustez frente a ataques adversarios.
Declaración sobre la transparencia de los procesos
Declaración de conflictos de intereses
Al seleccionar el equipo para este proyecto, aplicamos la versión 1.0 de nuestra política de conflictos de intereses, la cual estaba vigente al inicio del proyecto.
Al inicio del proyecto, un miembro del equipo se encontraba en discusiones con Anthropic sobre un posible puesto. Recibió una oferta y la rechazó. Además, este miembro del equipo poseía acciones en una empresa competidora, en su calidad de exempleado. Por ello, exigimos que todo el trabajo que aportó a la evaluación fuera revisado minuciosamente 6 por otro miembro del equipo sin conflictos de interés, quien asumió la responsabilidad personal de su exactitud. De ahora en adelante, nuestra política actualizada sobre conflictos de intereses, aplicable a las evaluaciones de riesgo iniciadas después del 9 de octubre de 2026, simplemente exigirá la abstención en una situación de este tipo.
Ninguna de las personas que trabajaron en este proyecto poseía acciones de Anthropic. Nuestra política de conflictos de intereses exige que un miembro del personal se abstenga de participar si tiene acciones en la empresa evaluada. (Nadie del personal de METR tiene acciones de Anthropic, pero sí una persona que se incorporará próximamente).
Consideramos que no hay otros conflictos que pudieran llevar a una persona razonable, ajena a METR, a confiar sustancialmente menos en esta evaluación.
Otras declaraciones.
Nuestras políticas de transparencia en los procesos nos exigen describir tanto las restricciones formales (por ejemplo, los derechos de supresión de información y publicación) como cualquier otro factor que haya podido influir en nuestros resultados. Con el fin de mitigar presiones informales, por lo general procuramos compartir suficientes pruebas pertinentes para que el público pueda sacar sus propias conclusiones; no obstante, en este caso, dicha labor resultó más compleja debido a la supresión de información. Por orden de impacto, de mayor a menor:
Teniendo en cuenta el impacto en las negociaciones con otras empresas y la posibilidad de que Anthropic revoque el acceso. Estas evaluaciones con empresas son voluntarias, y valoramos cómo este informe podría afectar nuestra capacidad de hacerlas en el futuro. Por ejemplo, si criticamos demasiado a Anthropic por las limitaciones de acceso o por ciertas supresiones, otras empresas, o la propia Anthropic, podrían estar menos dispuestas a trabajar con nosotros más adelante. En este sentido, los efectos más importantes son:
- Queremos evitar desincentivar a las empresas a compartir con nosotros evidencia relevante, aunque después oculten ciertos detalles, por lo que procuramos centrar el debate sobre las limitaciones derivadas de dichas supresiones en aquellos casos en los que estas han afectado nuestra capacidad para comunicar nuestras conclusiones e incertidumbres fundamentales.
- Evitamos ofrecer descripciones de procesos demasiado detalladas, ya que esto podría desincentivar a las empresas a realizar colaboraciones de carácter exploratorio, o bien hacerles sentir que deben tenerlo todo perfectamente definido, impidiéndoles cambiar de opinión o incorporar nueva información a medida que trabajan con nosotros. En su lugar, nos centramos en comunicar aquellos aspectos del proceso que han tenido un impacto significativo en nuestro resultado final.
Realizamos modificaciones importantes para mejorar la claridad, especialmente en la Revisión del informe de riesgos, en respuesta a los comentarios recibidos. Dicha revisión pasó por varias versiones, en parte debido a observaciones sustanciales por parte de Anthropic sobre la claridad en la comunicación y la necesidad de reducir el margen para interpretaciones malintencionadas o erróneas de nuestro informe. En algunos casos, consideramos que la retroalimentación dirigida al equipo de METR fue excesivamente enérgica; no obstante, Anthropic se mostró receptivo a nuestras observaciones al respecto, y esperamos establecer procesos y pautas más detallados para abordar estas situaciones en el futuro. No creemos que esto haya distorsionado de forma importante la evaluación final ni la “Revisión del informe de riesgos.”
Resumen de las condiciones del contrato.
A continuación resumimos los términos relevantes del contrato.
Alcance
Alcance. METR evalúa de forma independiente en qué medida los sistemas de IA están automatizando o acelerando la I+D de IA en Anthropic.
Derechos de acceso
Obligaciones de Anthropic. Anthropic proporciona el acceso que se indica a continuación, en la medida en que sea razonablemente necesario, así como un punto de contacto designado y asistencia razonable para organizar encuestas y entrevistas. Anthropic puede rechazar aquellas solicitudes que requieran un esfuerzo desproporcionado o que no superen su proceso de revisión de información; pero en ese caso explicará el motivo, describirá en términos generales qué información se ha retenido y ofrecerá alternativas, siempre que resulte viable.
Acceso otorgado a los investigadores. El contrato describe, como requisito mínimo para esta evaluación, diversos tipos de información a los que tuvimos acceso en colaboraciones anteriores. También detalla aspectos logísticos relacionados con las conversaciones con el personal de Anthropic. Más arriba describimos el acceso que finalmente obtuvimos.
Proceso de revisión de la información. Anthropic procura resolver las solicitudes de información en un plazo de tres días hábiles y designa una persona como punto de contacto para resolver dudas.
Derechos de publicación
Publicidad. Ninguna de las partes hace declaraciones públicas sobre el acuerdo sin la aprobación de la otra, con una excepción: ambas pueden informar que el acuerdo existe y cuál es su naturaleza general (una evaluación independiente de la I+D en IA y de la asignación de capacidad de cómputo).
Derechos de publicación de METR. METR tiene los siguientes derechos de publicación:
- Afirmaciones públicas aprobadas. METR somete a revisión de Anthropic sus propuestas de hallazgos públicos antes de su publicación. Anthropic puede exigir la supresión de información confidencial o no pública, y las partes discuten esas supresiones de buena fe, prevaleciendo las solicitudes de supresión formuladas por Anthropic. METR puede presentar en cualquier momento afirmaciones nuevas o modificadas para su aprobación.
- Sin necesidad de una revisión adicional, METR podrá publicar afirmaciones públicas aprobadas, información disponible al público (incluidas afirmaciones aprobadas anteriormente, por ejemplo, las que figuran en Frontier Risk Report), información que pueda derivarse de un modelo o documento una vez que este se haga público, así como los análisis o comentarios de la propia METR al respecto.
- Anthropic puede solicitar a METR un breve aplazamiento de cualquier declaración pública, sujeto a excepciones limitadas.
- Transparencia. METR siempre puede dar a conocer:
- la existencia y los términos generales del proceso de revisión y de supresión de información
- si Anthropic ejerció sus derechos de supresión de información
- si alguno de los hallazgos dependió de forma significativa de información suprimida
- el nivel de acceso que recibió METR
- el marco de confidencialidad.
Entregables
- Un informe completo: sin información suprimida, entregado a Anthropic, cubriendo todo el alcance del proyecto.
- Un informe interno de METR: el informe completo, tras una supresión limitada de información por parte de Anthropic, para compartirlo con el personal de METR. [Nota: este informe no se elaboró durante el proceso por motivos de tiempo.]
- Afirmaciones públicas: el informe público, aprobado mediante el proceso de supresión de información descrito en el apartado “Afirmaciones públicas aprobadas.”
Independencia y conflictos de interés
Independencia. METR lleva a cabo el proyecto y llega a sus conclusiones de forma independiente, y no entra en compromisos que lo hagan depender de Anthropic en lo financiero, lo operativo o de gestión. METR reduce al mínimo los conflictos de intereses y, en sus publicaciones dirigidas al público o a los reguladores, declara aquellos que una persona razonable del sector consideraría relevantes. METR mantiene la capacidad de evaluar a otros proveedores de IA. Anthropic no intentará influir en los hallazgos de METR de maneras que comprometan la integridad del proyecto, y METR conserva la facultad exclusiva de decidir la metodología y las conclusiones del proyecto.
Sin pago. Ninguna de las partes le paga a la otra. Los tokens y créditos que se entregan a los evaluadores de METR son gratuitos, y cada parte asume sus propios costos.
Lista de verificación AEF-1
A continuación reproducimos la lista de verificación AEF-1v1 del AI Evaluator Forum. Como referencia, puede consultarse la lista de verificación AEF que METR completó para su informe Reporte de riesgo de frontera (Frontier Risk Report) (p. 67).
1: Obtener acceso y recursos suficientes
| Ítem | Descripción | ¿Se cumple? | Notas/Evidencia |
|---|---|---|---|
| 1.1 | Requisito: el evaluador obtuvo el acceso técnico suficiente para analizar las características específicas del sistema objeto de la evaluación. | No | De los subapartados que aparecen a continuación, AEF-1 solo exige el 1.1.1 (acceso de consulta). El personal de METR no tuvo acceso de consulta a los modelos no lanzados de Anthropic, por lo que marcamos este ítem como no cumplido, aunque ese acceso no era fundamental para nuestra evaluación. Esta sección de la lista de verificación no resulta adecuada para esta evaluación. |
| 1.1.1 | El evaluador tuvo acceso de consulta. | No | El personal de METR que trabajó en esta evaluación no solicitó acceso de consulta, porque no lo consideramos fundamental para esta evaluación. |
| 1.1.2 | El evaluador tuvo acceso al andamiaje del sistema. | N/A | |
| 1.1.3 | El evaluador tuvo exenciones de las medidas de seguridad del sistema. | N/A | |
| 1.1.4 | El evaluador tuvo acceso a los estados intermedios del sistema. | N/A | |
| 1.1.5 | El evaluador tuvo acceso para hacer refinamientos (fine-tuning) del sistema. | N/A | |
| 1.1.6 | El evaluador tuvo acceso a los pesos del modelo. | N/A | |
| 1.1.7 | El evaluador recibió acceso a otras herramientas para la elicitación de capacidades o para contribuir, de otro modo, a la validez externa. | N/A | |
| 1.1.8 | El evaluador tuvo acceso a datos relevantes de los usuarios. | N/A | |
| 1.2 | Recomendación: el proveedor del sistema compartió con el evaluador la información relevante para llevar a cabo una evaluación fiable y útil. | Sí | Anthropic compartió información con METR caso por caso, tal como se ha descrito anteriormente. |
| 1.3 | Requisito: El evaluador tuvo acceso a recursos computacionales suficientes para llevar a cabo una evaluación exhaustiva. | Sí | Esta evaluación no requirió grandes recursos de cómputo por parte de METR. |
| 1.4 | Requisito: El evaluador dispuso de tiempo suficiente para llevar a cabo una evaluación exhaustiva. | Sí | El periodo de colaboración se extendió de 4 a 11 semanas (del 12 de agosto al 29 de octubre). En la sección de detalles del proceso describimos el cronograma con más detalle. |
| 1.5 | Recomendación: El proveedor del sistema otorgó protección legal para las acciones del evaluador que se encuentren dentro del alcance acordado de la evaluación. | No solicitado |
2: Conflictos de interés minimizados
| Ítem | Descripción | ¿Se cumple? | Notas/Evidencia |
|---|---|---|---|
| 2.1 | Requisito: El evaluador no recibió una compensación condicionada a los resultados de la evaluación. | Sí | METR no solicitó ni recibió compensación por esta evaluación. Anthropic proporcionó computadoras portátiles y créditos de tokens para la evaluación. |
| 2.2 | Requisito: El proveedor del sistema no ejerció control organizacional ni financiero sobre el evaluador. | Sí | |
| 2.3 | Requisito: El evaluador ha publicado una política de conflictos de interés, y esta se aplicó a la evaluación | Sí | Aplicamos la versión 1.0 de nuestra política de conflictos de interés al seleccionar al equipo para este proyecto, que era la política vigente al inicio del proyecto. Desde entonces, hemos actualizado nuestra política de conflictos de interés. |
| 2.4 | Requisito: El evaluador divulgó claramente los conflictos de interés relevantes para la evaluación. | Sí | |
| 2.4.1 | ¿Recibió el evaluador un pago del proveedor del sistema o de un competidor directo de este para realizar la evaluación? | No | |
| 2.4.2 | ¿Hay una parte significativa del financiamiento del evaluador que proviene del proveedor del sistema, de sus empleados o de sus competidores directos? | No | |
| 2.4.3 | ¿Poseen el proveedor del sistema, sus empleados o sus competidores directos participación accionaria en la organización evaluadora? | No | |
| 2.4.4 | ¿Posee el personal del evaluador que llevó a cabo la evaluación participación accionaria en el proveedor del sistema o en sus competidores directos? | Sí | Véase la discusión sobre conflictos de interés y las medidas de mitigación en la declaración de conflictos de interés. |
| 2.4.5 | ¿Hay algún miembro del personal que participa en la evaluación que trabaje simultáneamente para el proveedor del sistema o sus competidores directos? | No | |
| 2.4.6 | ¿Tenía el evaluador algún otro conflicto de interés relevante para la evaluación? | Sí | Véase la discusión sobre conflictos de interés y las medidas de mitigación en la declaración de conflictos de interés. |
| 2.5 | Requisito: El evaluador excluyó de participar en la evaluación a toda persona con un interés financiero significativo en el proveedor del sistema. | Sí | |
| 2.6 | Recomendación: El evaluador divulgó cualquier otro acuerdo con el proveedor del sistema que afecte significativamente la independencia y la fiabilidad de la evaluación. | Sí | METR tiene otros acuerdos de evaluación independiente con Anthropic. Cabe señalar también que el trabajo de METR con modelos no públicos y el uso de tokens gratuitos incentivan una relación cordial con las empresas de IA. Véase nuestro sitio web. |
3: Autonomía de análisis
| Ítem | Descripción | ¿Se cumple? | Notas/Evidencia |
|---|---|---|---|
| 3.1 | Recomendación: El evaluador mantuvo la flexibilidad para definir qué propiedades específicas del sistema evaluar. | Sí | METR tuvo plena flexibilidad sobre la naturaleza de la investigación, dentro del alcance definido en el contrato. |
| 3.2 | Requisito: El evaluador tuvo autonomía para decidir los métodos de la evaluación. | Sí | |
| 3.3 | Recomendación: El evaluador ejecutó las evaluaciones por sí mismo mediante acceso directo al sistema. | No | El personal de METR asignado a esta evaluación nunca tuvo acceso directo a los sistemas de Anthropic, pero se le dio acceso a numerosos conjuntos de datos y documentos. |
| 3.4 | Requisito: El evaluador conservó control editorial sobre la forma de presentar los resultados de su evaluación. | Sí | Anthropic no tuvo control editorial sobre el informe final, pero sí tuvo control sobre qué información no pública METR podía incorporar en él. Véanse los detalles del proceso y las declaraciones de transparencia del proceso. |
4: Transparencia de métodos y resultados
| Ítem | Descripción | ¿Se cumple? | Notas/Evidencia |
|---|---|---|---|
| 4.1 | Requisito: El evaluador compartió suficientes detalles metodológicos para permitir una revisión independiente de los resultados. | No | Esto no fue posible debido a los requisitos de supresión de información confidencial. |
| 4.2 | Recomendación: El proveedor del sistema otorgó de antemano cualquier derecho necesario para divulgar los resultados a los destinatarios previstos de la evaluación | No | Como parte de esta evaluación, Anthropic tenía derecho a suprimir cualquier información no pública de esta publicación. De acuerdo con nuestro enfoque de transparencia, teníamos derecho a divulgar si Anthropic ejerció su derecho de supresión, y si alguno de nuestros hallazgos dependía significativamente de información suprimida. |
| 4.3 | Recomendación: El público previsto para la evaluación no se redujo según los resultados. | Sí | |
| 4.4 | Recomendación: El proveedor del sistema no distorsionó los hallazgos de la evaluación. | Sí | A fecha de la fecha límite ampliada (3 de noviembre). |
| 4.5 | Recomendación: Ni el proveedor del sistema ni terceros retrasaron indebidamente la divulgación de la evaluación debido al contenido de sus resultados. | Sí | Véase la discusión en la sección de declaración de transparencia del proceso. |
| 4.6 | Requisito: El proveedor del sistema no tenía la facultad de suprimir resultados con el fin de ocultar hallazgos preocupantes. | No | Anthropic tenía derechos unilaterales de supresión de información. |
| 4.7 | Recomendación: El evaluador divulgó claramente las facultades de supresión de información otorgadas al proveedor del sistema o a otras entidades externas. | Sí |
5: Protección de información sensible
| Ítem | Descripción | ¿Se cumple? | Notas/Evidencia |
|---|---|---|---|
| 5.1 | Requisito: El evaluador contaba con el permiso del proveedor del sistema para publicar cualquier resultado basado en información o sistemas no públicos. | Sí | Toda la información del informe público de METR fue aprobada expresamente por Anthropic para su publicación. |
| 5.2 | Recomendación: Los métodos de evaluación no fueron manipulados ni filtrados. | N/A | Es menos relevante para nuestra evaluación de I+D en IA automatizada. Más arriba se discuten algunas formas en que podríamos haber sido inducidos al error. |
| 5.3 | Requisito: El evaluador implementó medidas para proteger toda información confidencial que recibió del proveedor del sistema. | Sí | La evaluación se realizó en dispositivos de la empresa, y los evaluadores de METR siguieron nuestra política de confidencialidad. |
| 5.4 | Requisito: El evaluador estableció y siguió una política de divulgación responsable. | No | METR no ha establecido una política de divulgación responsable. |
Registro de actualizaciones
6 de noviembre de 2026
Hicimos los siguientes cambios en la lista de verificación AEF-1:
- Eliminamos las notas de plantilla que habían quedado en los ítems 1.1 y 2.4.
- Corregimos el ítem 1.1 de «Sí» a «No» y modificamos sus notas en consecuencia.
- Aplicamos sangría a las filas de los subapartados.
Notas
-
Coincidimos en que las supresiones de Anthropic se limitaron a información confidencial que podría acelerar el trabajo de otros desarrolladores de IA, aunque la mayor parte de la información suprimida era de carácter muy general. No nos pronunciaremos sobre si estas supresiones estaban justificadas en su conjunto, ya que no creemos que METR esté en una posición adecuada para comparar el interés comercial de una empresa en preservar esta información confidencial frente al interés público en comprender mejor los riesgos del desarrollo de la IA. En su lugar, nos centramos en describir la naturaleza de estas supresiones y cómo afectaron nuestras conclusiones. ↩︎
-
Autores: Tom Cunningham, Nate Rush, Parker Whitfill y Hjalmar Wijk. ↩︎
-
METR ha publicado diversas líneas de investigación relevantes para la aceleración de la I+D en IA, con resultados que apuntan en ambas direcciones: nuestras tendencias de horizonte temporal sugieren un progreso rápido, mientras que nuestro estudio de 2025 sobre la productividad de los desarrolladores encontró que las herramientas de IA de principios de 2025 provocaron una ralentización; nuestras estimaciones de futuros cuellos de botella en capacidad de cómputo apuntan a límites al escalamiento, y nuestro análisis sobre cómo las pruebas de referencia (“benchmarks”) sobrestiman el progreso de la IA advierte contra sacar demasiadas conclusiones de las cifras principales. ↩︎
-
Cuatro autores principales trabajaron en este informe. Otros dos empleados de METR dedicaron tiempo a apoyar y supervisar este trabajo. ↩︎
-
Un problema distinto son las pruebas de referencia (benchmarks) diseñadas para tener un resultado interpretable, por ejemplo, si las tareas de SWE-bench no se ajustan a la descripción de “resolver problemas de GitHub.” Nosotros usamos AECI como un índice de capacidad general de tipo “caja negra,” por lo que no nos afectan estos problemas de descripción de los benchmarks. ↩︎
-
Según nuestra política de conflictos de interés, esto significa aplicar al menos el nivel de revisión habitual de las investigaciones de METR, lo que supone comprender los datos y el análisis lo suficientemente bien como para poder evaluar la validez de las conclusiones, e incluir verificaciones de consistencia, conocer la procedencia de las estadísticas y revisar parte de los datos subyacentes. ↩︎