AI 驱动的自身研发提速,是否会让模型能力提升大幅加快?本文讨论评估方可以怎样研究这一问题。要完成这类评估,需要回答:
- 模型能力提升速度:内部在研模型的能力提升有多快,最近又快了多少?
- AI 带来的加速:如果确实在加速,其中有多少是 AI 自动化推动的,又有多少是因为其他因素?
- 未来能力增长的瓶颈:短期内是否存在重要瓶颈,可能拖慢模型能力提升,或削弱加速势头?
- 评估局限:如果 AI 能力提升出现远超以往的加速,这套评估方法能可靠地检测出来吗?
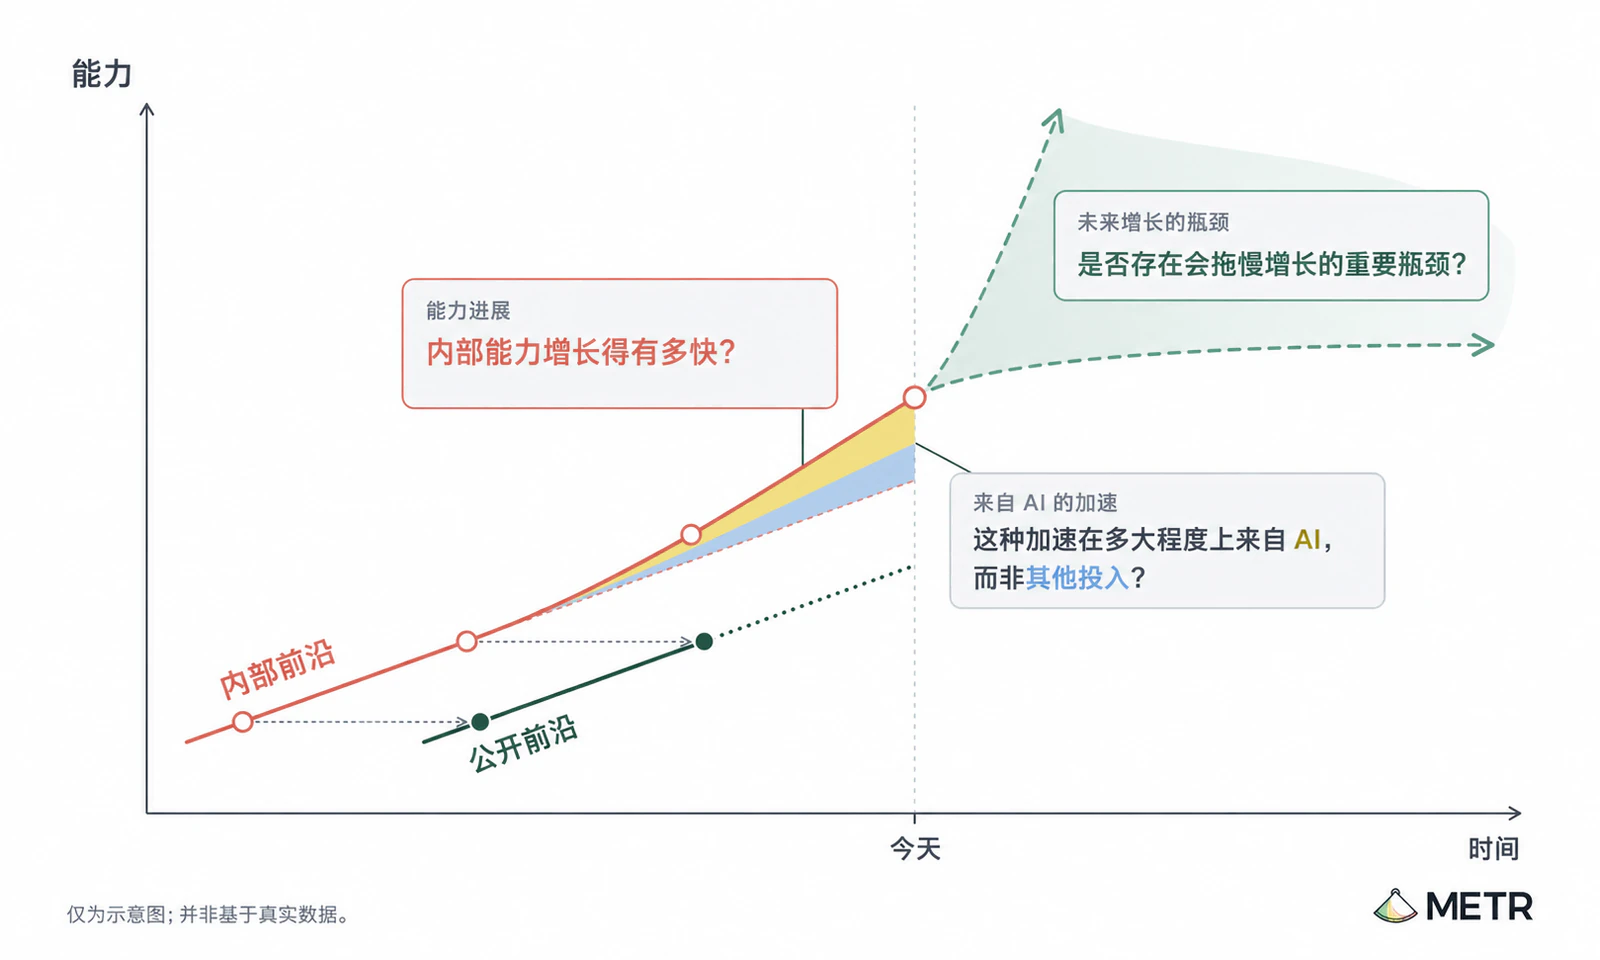
这项评估需要分析尚未发布的模型的能力,并了解 AI 研发的关键投入(人力、算力、数据和算法)增长了多少;还需要与相关研究人员坦诚交流,了解 AI 如何影响了他们的工作。评估方具体需要哪些资料和权限,详见下文。
评估范围
模型能力提升速度
要判断模型能力进展是否在加速,评估方必须获取模型在不同时期的能力数据。了解 AI 能力不能只靠一种方法1,因此评估方需要通过多种方式收集数据,包括:
- 基准测试:从各类能力基准测试(以及 ECI 等综合指标)来看,模型能力提升快了多少?
- 中间指标:从关键的中间指标或先行指标(如预训练损失)来看,提升速度快了多少?
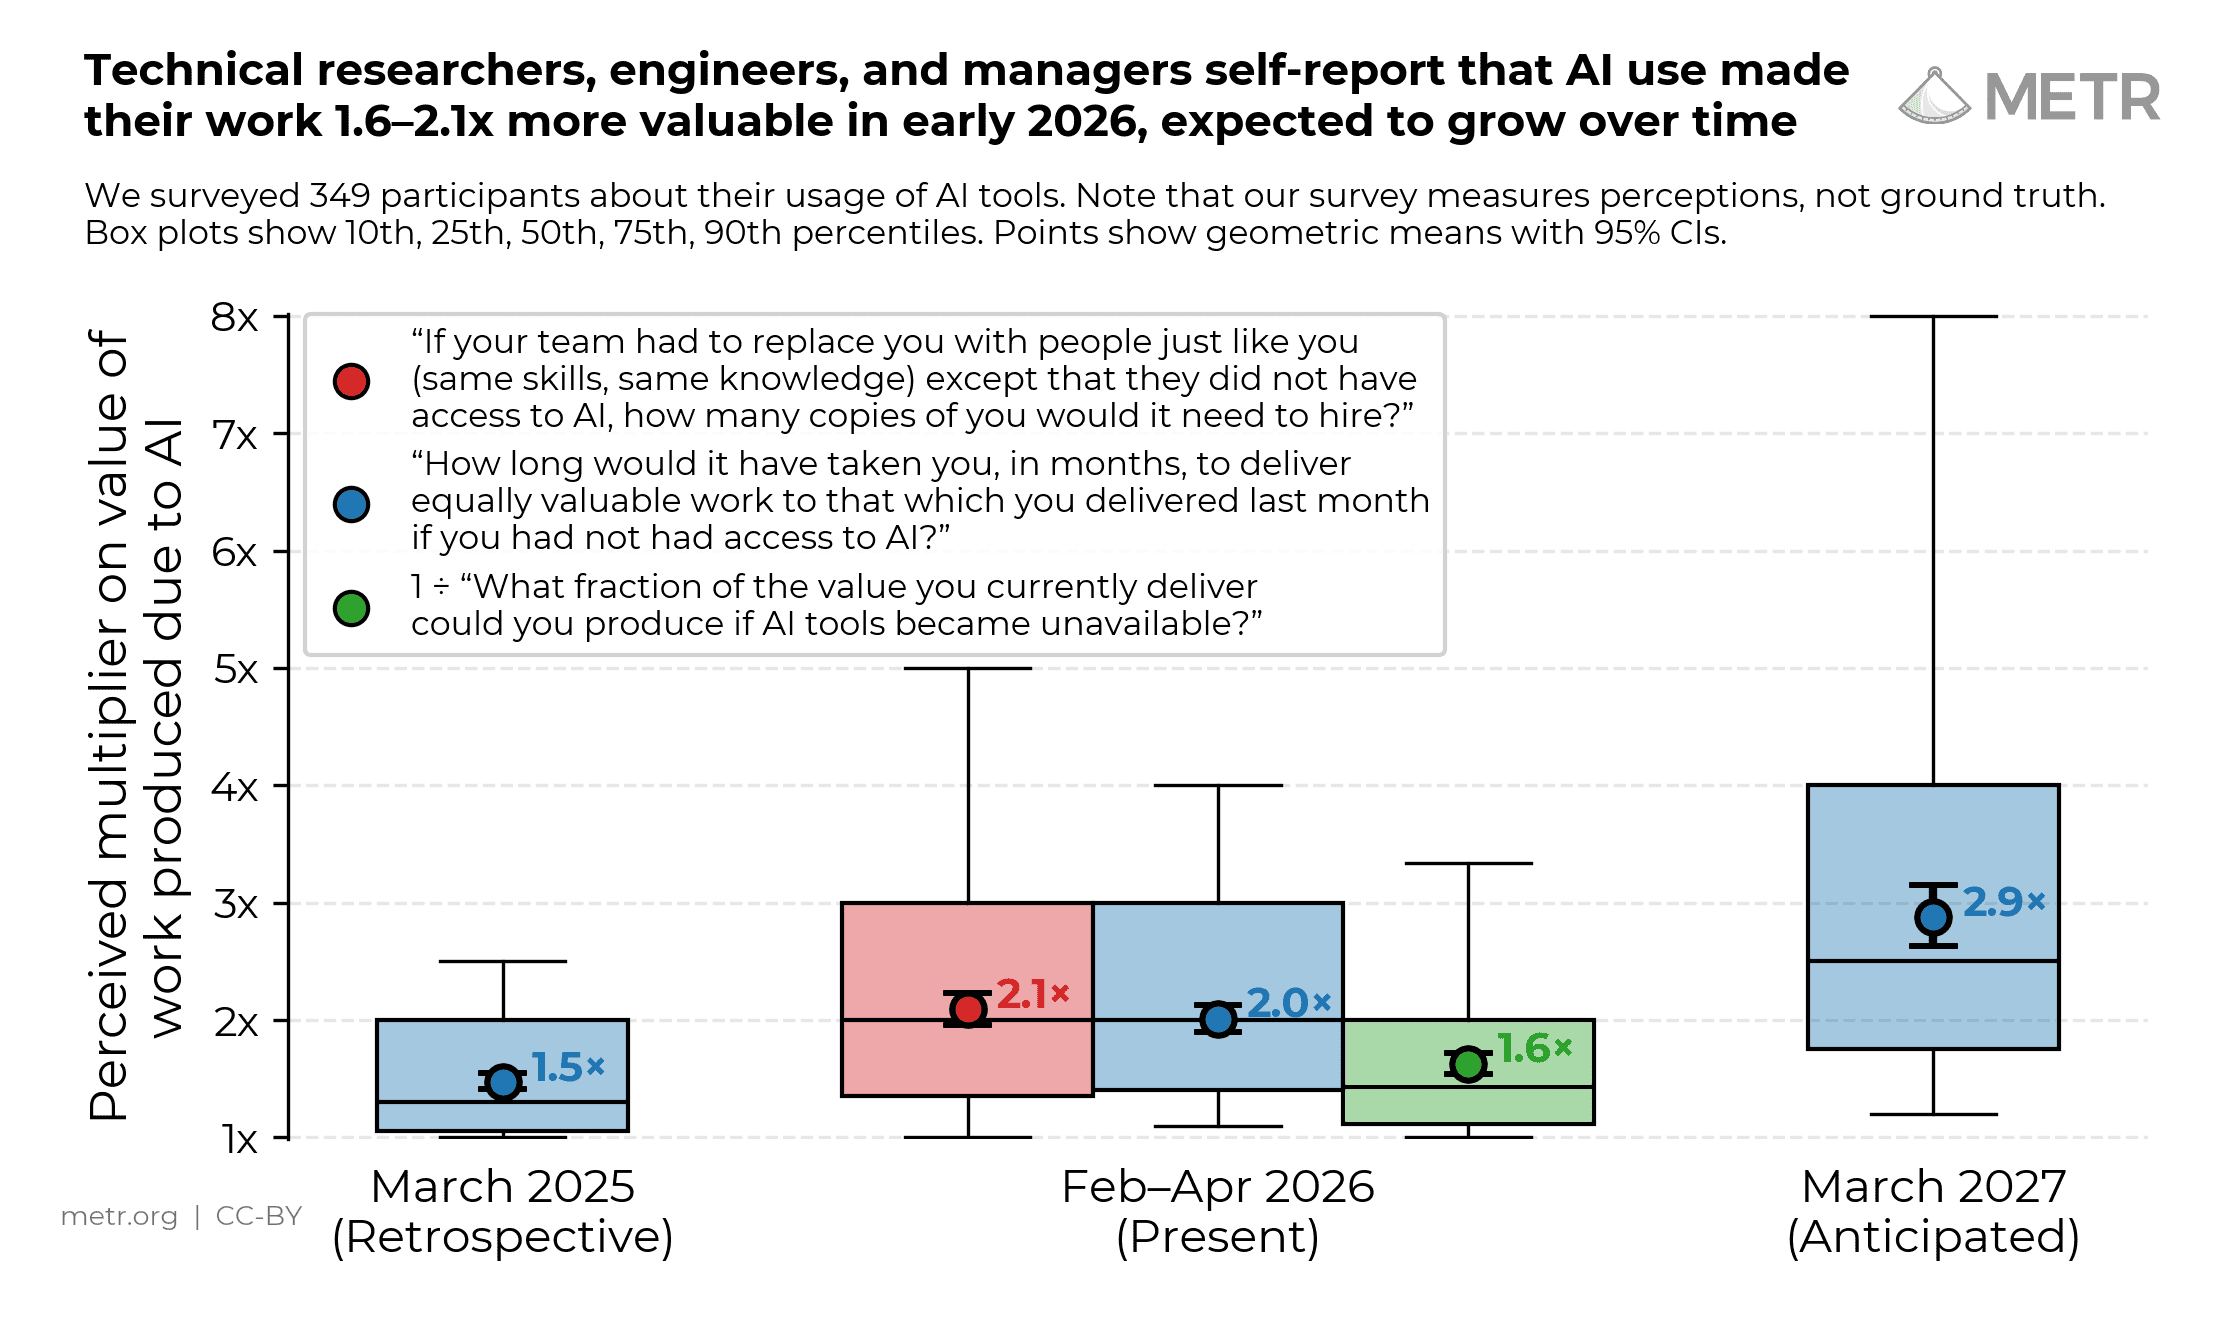
- 主观感受:从访谈或调查来看,使用内部模型的研究人员是否感到模型的能力在加速提升?
- 其他:对于理解模型能力提升速度,还有哪些代理指标至关重要?这些指标目前是什么趋势?
AI 带来的加速
要判断模型能力提升速度加快,是不是由 AI 推动的,评估方需要分析哪些投入最可能受到 AI 自动化的影响。为此,需要评估下面几点:
- 模型能力提升加速,有多少是因为算法进步或数据,又有多少是因为扩大算力等受 AI 自动化影响较小的其他投入?
- 算法进步或数据方面的加速,有多少是因为 AI 辅助或自动化,又有多少是因为实验算力、人力等其他投入?
未来能力增长的瓶颈
接下来,评估方需要判断:是否有理由认为,AI 能力的增长或提速势头会在近期放缓。为此,需要回答:
- 近期是否会出现重要瓶颈(例如训练算力、人类数据),拖慢 AI 的能力提升?这些瓶颈会如何影响 AI 短期内的能力增长?
评估局限
评估方还需考察,公众应该有多大把握相信,一旦出现大幅加速,会有人及时发现并对外通报?为此,需要回答:
- 内部模型能力到底提速了多少、该归因到哪些因素,相关估算又有多可靠?证据来源方面,最需要担心的是什么?
- 研究涉及的内部证据,与外界公开可见的加速证据相比,情况如何?如有差异,可能是什么原因?
- 总体来看,如果 AI 能力提升出现远超以往的加速,这套评估方法能可靠地检测出来吗?
评估所需的数据调阅权限详述
要回答这些问题,评估方需要模型开发各环节的投入和产出数据。只要条件允许,数据就应覆盖尽可能长的时间跨度,并逐条标明确切日期,以便评估方对照历史基线,观察数据变化。必要时,还应分团队、分领域给出数据,以便评估方把投入方面的具体变化同研究产出对应起来。
必需的访问权限 | 有则更好的访问权限 |
|---|---|
|
|
出于安全考虑,可以在研发机构的硬件上分析数据(必要时也可以到研发机构现场分析)。这项评估几乎不需要访问研发机构的基础设施。
所需数据包括:
内部模型能力的测量数据
评估方需要获取内部模型能力随时间变化的测量数据,以判断能力提升是否在加快。具体包括:
- 基准测试数据。所有前沿模型(包括仅供内部使用的模型)在各项已测基准上的得分,用于计算 ECI 和其他衡量进展的指标。为确保结果稳健,还应提供每项基准测试的详情,包括题目示例、评分细则和模型作答样例。
- 研究人员提供的定性与定量信息。研究人员已有的观察与思考(如访谈摘录或内部调查)有助于理解这些研究人员对 AI 能力变化的看法。除此之外,还应安排评估方直接访谈员工,作为补充信息。
- 关键领域的总体进展指标。详细说明预训练、后训练及模型开发其他关键环节的进展跟踪方式、衡量进展,以及各环节的历史进展记录。研发机构如果能进一步补充细节和分析,说明他们如何看待关键领域对整体 AI 能力进步的推动作用(如预训练和后训练各自贡献了多少进展),可能也会很有价值。这样,评估方就能更准确地估计,关键领域的提速会在多大程度上带动整体模型能力的提速。
- 其他内部能力指标。为确保结果稳健,公司如有其他内部能力指标,也应一并提供。
算法进展估算
我们预计,研发机构目前应该对预训练、后训练等关键领域的算法进展做过估算。研发机构尚未公开估算方法的具体细节,但他们的思路可能和这篇论文类似:达到特定性能水平所需的算力降了多少,就算是取得了多大进展。
评估方不需要研究进展的具体细节,但需要拿到这些进展实际成效的估算结果。相关估算应反映成效随时间的变化(精确到天),以及不同模型之间的差异。理想情况下,对算法进展的估算应尽可能细分,以便灵活分析。
体现 AI 助力研发的证据
“如果完全不使用 AI 工具,AI 研发的进展会如何”?这一反事实的假设很难有明确结论。因此,我们预计,要准确估算 AI 对自身研发的影响,需要多条证据相互参照。要回答这个问题,应优先收集哪些具体数据?我们预计,评估方与研究人员的交流会很有参考价值。以下列出几类可能有用的证据,以供参考:
- AI 智能体开支。理想情况下,这类开支应按团队和时间细分,以 token 用量和推理成本计。
- 研究人员的实操案例自述。研究人员借助模型推进研究,一件件具体经历,能让评估方深入了解 AI 正在如何影响自身的研发过程。
- 工作效率估算。包括一些粗略指标,例如每位研究人员每天写多少行代码,或是研究人员自报的工作效率随时间提高了多少。
关键研发投入的统计数据
AI 以外的投入也可能加快能力2或算法进步。因此,有必要了解其他关键投入的增长情况。要剔除其他因素的影响,就需要以下相应数据:
- 人力投入。各关键领域团队的规模,按时间给出。
- 算力投入:
- 训练算力。每个模型在预训练、中期训练、后训练等环节分别使用了多少算力。
- 实验算力。按时间给出用量,并按团队和用途细分。
- 数据投入。具体取决于领域,预训练数据,或是强化学习环境都可能涉及。
- 其他关键投入。如果还有外界不知道的关键投入,也应向评估方说明。
瓶颈及预测详情
应向评估方提供足够的信息,以便评估方预测 AI 模型未来的能力发展趋势,并判断短期内 AI 模型能力有多大可能达到危险的临界阈值。
理想情况下,应向评估方开放:
- 瓶颈信息。对于可能出现的瓶颈,应向评估方提供详细证据,说明这些判断有多大可能成立。
- 已有预测。如已有总体指标预测,评估方应当能获取相关预测及其详细依据。
这类面向未来的估算很难保证准确,最终报告中也应如实说明。
员工访谈
为了结合具体情况准确理解上述信息,并确保没有遗漏,评估方必须能直接与研究人员交谈。
评估方需要访谈模型训练各个重要环节的参与员工,确认自己对数据的理解是否准确,并了解是否还遗漏了其他重要数据来源。访谈对象应包括熟悉预训练、强化学习和基础设施的研究人员。
另外,与更了解全局的研究人员进一步交流,往往也会对评估大有帮助。例如,研发机构内部负责模型能力进展和能力加速情况的研究人员,或负责关键领域的管理人员。
-
例如,光看基准测试分数,会容易高估模型能力,因为测试能过,不代表模型在真实场景中也同样好用。研究人员给出的“提速”量化估计,也可能会夸大模型能力,因为反事实(“如果不用 AI,同样任务要花多久”)的情况很难准确估算;没有这个参照,所谓的提速到底提了多少,也很难判断。 ↩
-
例如,如果算力投入增幅远超常规,那模型能力提升也可能会随之超出正常水平。 ↩